- Published on
Sentry로 프론트엔드 운영 오류 추적하기
- Authors
- Name
- GW
개요
개발 환경에서는 문제가 없었는데 실제 서비스에서만 오류가 발생하는 경우가 있습니다.
특히 프론트엔드는 서버와 달리 개발자가 통제하기 어려운 다양한 환경에서 실행됩니다.
개발 환경에서는 정상 동작
↓
Production 환경에 서비스 배포
↓
다양한 브라우저와 사용자 기기에서 코드 실행
↓
특정 환경이나 사용자 흐름에서만 오류 발생
↓
개발자가 직접 재현하기 어려움
브라우저의 개발자 도구를 직접 확인할 수 있는 개발 환경과 달리, 실제 사용자의 브라우저에서 발생한 오류는 사용자가 알려주지 않는다면 발생 여부조차 알기 어려울 수 있습니다.
사용자로부터 "버튼을 눌렀는데 아무것도 안 돼요." 같은 제보를 받더라도 이것만으로는 원인을 찾기 어렵습니다.
어떤 페이지에서 발생했는지, 어떤 JavaScript 오류가 발생했는지, 어느 코드에서 시작된 문제인지와 같은 정보가 필요하기 때문입니다.
이러한 문제를 해결하기 위해 서비스에 Sentry가 필요합니다.
처음에는 단순히 발생한 오류를 수집하는 도구라고 생각할 수 있지만, 실제 운영 환경에서 사용하면서 중요한 것은 오류를 많이 수집하는 것이 아니라 원인을 찾는 데 필요한 정보를 수집하는 것이라는 점을 알게 되었습니다.
이번 글에서는 Next.js 서비스에서 Sentry를 활용했던 경험을 바탕으로 운영 환경의 오류를 어떻게 수집하고, 노이즈를 줄이며, 실제 원본 코드까지 추적할 수 있는지 살펴보겠습니다.
주요 내용은 다음과 같습니다.
- Client와 Server 오류 수집
- Stage와 Production 환경 분리
- 예상 가능한 오류 Filtering
- Stack Trace와 추가 Context 활용
- Source Map을 통한 원본 코드 추적
- 운영 오류 모니터링에서 고려해야 할 점
개발 환경에서는 재현되지 않는 오류를 어떻게 찾을까?
개발 중 발생하는 오류는 비교적 찾기 쉽습니다.
브라우저 Console이나 개발 서버의 Terminal을 확인할 수 있고, 문제가 발생한 동작을 직접 반복하면서 원인을 추적할 수도 있습니다.
하지만 Production 환경은 다릅니다.
사용자 브라우저에서 오류 발생
↓
화면이 정상적으로 동작하지 않음
↓
개발자는 사용자의 Console을 직접 확인할 수 없음
↓
어떤 오류가 발생했는지 알기 어려움
↓
재현 조건과 원인을 찾는 데 많은 시간이 필요
더 어려운 점은 모든 사용자가 같은 환경을 사용하지 않는다는 것입니다.
브라우저와 OS 버전이 다를 수 있고, 네트워크 상태나 사용자 데이터, 특정 페이지 이동 순서에 따라서만 문제가 발생할 수도 있습니다.
따라서 운영 중인 서비스에서는 오류가 발생한 순간의 정보를 개발자가 확인할 수 있는 관측 환경이 필요합니다.
Sentry와 같은 오류 모니터링 도구가 이 역할을 합니다.
단순히 "오류가 발생했다"는 사실을 기록하는 것보다 어떤 상황에서 어떤 오류가 발생했는지 추적할 수 있도록 만드는 것이 핵심입니다.
Sentry는 어떤 문제를 해결해줄까?
Sentry는 애플리케이션에서 발생하는 오류와 성능 정보를 수집하고 분석을 도와주는 Observability 도구입니다.
Next.js에서는 @sentry/nextjs SDK를 통해 브라우저뿐만 아니라 서버에서 발생하는 오류도 수집할 수 있습니다.
프론트엔드 서비스에서 Sentry를 사용하는 흐름을 단순화하면 다음과 같습니다.
Next.js 애플리케이션 실행
↓
Client 또는 Server에서 오류 발생
↓
Sentry SDK가 오류 Event 수집
↓
Stack Trace와 실행 Context 함께 전달
↓
관련 오류를 Sentry의 Issue에서 확인
↓
오류 발생 위치와 원인을 분석해 문제 대응
↓
운영 환경의 문제 원인 추적
여기서 중요한 것은 Sentry가 오류 자체를 해결해주는 것은 아니라는 점입니다.
Sentry의 역할은 개발자가 실제 운영 환경에서 발생한 문제를 발견하고 원인을 추적할 수 있도록 정보를 제공하는 것에 가깝습니다.
따라서 SDK를 설치하는 것만으로 끝나는 것이 아니라
- 어떤 환경의 오류를 수집할 것인지
- 어떤 오류를 제외할 것인지
- 오류와 함께 어떤 정보를 전달할 것인지
- Production 코드의 위치를 어떻게 원본 코드와 연결할 것인지
같은 부분도 함께 고려해야 합니다.
Next.js의 오류는 어디에서 발생할까?
Next.js 애플리케이션은 코드가 한 곳에서만 실행되지 않습니다.
크게 보면 브라우저에서 실행되는 Client 영역과 서버에서 실행되는 영역이 존재합니다.
Next.js Application
↓
코드가 실행되는 Runtime에 따라 구분
↓
┌─────────────────────────────┬─────────────────────────────┐
│ Client                      │ Server                      │
│ Browser Runtime             │ Server Runtime              │
│                             │                             │
│ 버튼 클릭 중 JavaScript Error  │ Server Rendering 중 Error    │
│ localStorage 사용 중 Error    │ Data Fetching 중 Error       │
│ 사용자 Interaction 중 Error   │ Server Logic 실행 중 Error    │
└─────────────────────────────┴─────────────────────────────┘
↓
각 Runtime에서 서로 다른 Error 발생 가능
따라서 운영 오류를 제대로 관찰하려면 한쪽만 보는 것보다 코드가 실제로 실행되는 환경을 고려해 오류를 수집하는 것이 중요합니다.
Client Error 수집
Client에서는 사용자의 브라우저에서 JavaScript가 실행됩니다.
예를 들어 다음과 같은 오류가 발생할 수 있습니다.
사용자가 버튼 클릭
↓
Event Handler 실행
↓
예상하지 못한 데이터에 접근
↓
JavaScript Runtime Error 발생
↓
Sentry가 Client Error 수집
↓
오류 정보와 Browser Context 전달
현재 Sentry의 Next.js SDK에서도 Client 환경을 위한 초기화 설정을 구성할 수 있습니다.
개념적으로는 다음과 같이 Sentry를 초기화합니다.
import * as Sentry from '@sentry/nextjs';

Sentry.init({
  dsn: process.env.NEXT_PUBLIC_SENTRY_DSN,
});
실제 설정 파일의 위치와 구성 방식은 Next.js와 Sentry SDK 버전에 따라 달라질 수 있기 때문에 적용할 때는 현재 공식 문서를 확인하는 것이 좋습니다.
*Sentry - Next.js Manual Setup
Server Error 수집
Next.js에서는 브라우저뿐만 아니라 서버에서도 코드가 실행됩니다.
따라서 서버에서 발생한 오류 역시 관찰할 필요가 있습니다.
사용자가 페이지 요청
↓
Next.js Server에서 요청 처리
↓
Server Rendering / Data Fetching 등의 서버 코드 실행
↓
처리 과정에서 Runtime Error 발생
↓
Sentry가 Server Error 수집
↓
서버에서 발생한 오류의 실행 흐름 확인
이렇게 Client와 Server 양쪽의 오류를 수집하면 단순히 브라우저에서 발생한 JavaScript 오류뿐만 아니라 Next.js 애플리케이션의 여러 실행 환경에서 발생하는 문제를 관찰할 수 있는 기반을 만들 수 있습니다.
Stage와 Production 오류를 분리해서 보기
오류 수집을 시작하면 또 다른 문제가 생깁니다.
Stage 환경에서 테스트하면서 발생한 오류와 실제 사용자가 사용하는 Production 환경 오류가 함께 들어올 수 있습니다.
Stage 테스트 중 발생한 오류 ─────┐
                            ├─→ 하나의 오류 목록에 섞임
Production 사용자 오류 ────────┘
이렇게 되면 실제 운영 장애인지 개발 테스트 과정에서 발생한 오류인지 구분하는 과정이 추가로 필요합니다.
Sentry에서는 Event에 environment 정보를 지정할 수 있습니다.
예를 들어 다음과 같이 실행 환경을 전달할 수 있습니다.
import * as Sentry from '@sentry/nextjs';

Sentry.init({
  dsn: process.env.NEXT_PUBLIC_SENTRY_DSN,
  environment: process.env.NEXT_PUBLIC_APP_ENV,
});
그러면 개념적으로 다음과 같이 오류를 구분할 수 있습니다.
Stage에서 오류 발생
↓
environment = staging
↓
Stage 환경의 오류로 수집
Production에서 오류 발생
↓
environment = production
↓
실제 운영 환경의 오류로 수집
프로젝트 규모나 운영 정책에 따라 하나의 Sentry Project 안에서 environment로 구분할 수도 있고, 서비스 또는 환경별로 Project 자체를 분리하는 방법도 고려할 수 있습니다.
반복되는 오류와 Noise 줄이기
운영 환경에서는 동일하거나 유사한 오류가 여러 사용자에게 반복해서 발생할 수 있습니다.
예를 들어 하나의 Hydration Error가 여러 사용자에게 발생했다고 해서 각각을 완전히 별개의 문제로 관리한다면 실제로 확인해야 할 Issue가 지나치게 많아질 수 있습니다.
Sentry는 이를 줄이기 위해 발생한 모든 Error Event를 각각 별개의 Issue로 보여주는 것이 아니라, Stack Trace, Exception, Message 등의 정보를 분석해 관련된 Event를 하나의 Issue로 Grouping합니다.
개념적으로는 다음과 같습니다.
사용자 A → Hydration Error 발생
사용자 B → 유사한 Hydration Error 발생
사용자 C → 유사한 Hydration Error 발생
↓
Sentry가 Event의 특성 분석
↓
관련된 Event를 하나의 Issue로 Grouping
↓
Issue 단위로 오류 추적
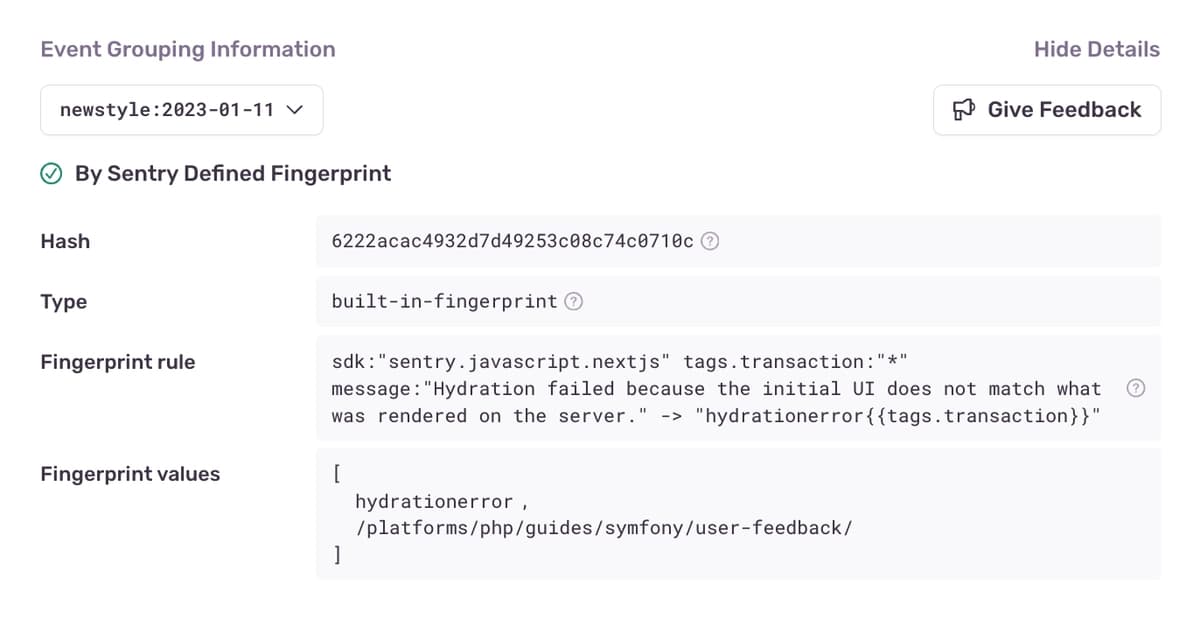
위 그림은 Sentry가 Fingerprint를 이용해 Event를 어떤 Issue로 Grouping할지 판단한 정보를 보여줍니다.
Fingerprint rule에서는 어떤 규칙을 기준으로 Grouping했는지 확인할 수 있고, Fingerprint values에서는 실제 Grouping에 사용된 값을 확인할 수 있습니다.
그림에서는 Hydration Error의 특성을 바탕으로 Fingerprint가 만들어진 것을 볼 수 있습니다.
Error Event 발생
↓
Stack Trace, Exception, Message 등의 정보 분석
↓
Fingerprint 결정
↓
관련된 Event를 하나의 Issue로 Grouping
이를 통해 동일하거나 유사한 오류가 반복해서 발생하더라도 개발자는 개별 Event를 하나씩 확인하기보다 Issue 단위로 오류의 발생 횟수와 영향을 파악할 수 있습니다.
모든 오류를 수집하는 것이 좋은 것은 아니다
처음 오류 모니터링을 구성하면 이런 생각을 하기 쉽습니다.
발생하는 오류를 전부 수집하면 더 많은 문제를 발견할 수 있지 않을까?
하지만 실제 운영에서는 그렇지 않을 수 있습니다.
서비스에는 개발자가 대응해야 하는 오류뿐만 아니라 예상 가능한 오류나 반복적으로 발생하지만 실제 장애와 직접적인 관련이 없는 오류도 존재할 수 있습니다.
서비스에서 발생하는 Error
↓
실제 대응이 필요한 오류,
예상 가능한 오류,
반복적으로 발생하는 Noise
↓
모든 오류를 동일하게 수집하면 Noise 증가
↓
중요한 운영 오류를 찾기 어려워짐
Sentry에서는 이러한 문제를 줄이기 위해 Event Filtering을 위한 여러 방법을 제공합니다.
예상 가능한 오류 Filtering
간단한 방법 중 하나는 ignoreErrors를 사용하는 것입니다.
import * as Sentry from '@sentry/nextjs';

Sentry.init({
  dsn: process.env.NEXT_PUBLIC_SENTRY_DSN,

  ignoreErrors: ['예상된 유효성 검증 오류'],
});
ignoreErrors에는 문자열이나 정규식을 사용해 특정 오류 메시지와 일치하는 Event를 제외할 수 있습니다.
하지만 여기서 주의해야 할 점이 있습니다.
단순히 Sentry 화면을 깨끗하게 만들기 위해 오류를 제외해서는 안 됩니다.
오류가 반복적으로 발생
↓
바로 ignoreErrors에 추가 X
↓
오류의 발생 원인 확인
↓
서비스에서 예상한 동작인지 판단
↓
개발자가 대응해야 하는 문제인지 확인
↓
대응할 필요가 없는 Noise라면 Filtering 검토
예를 들어 로그인하지 않은 사용자가 인증이 필요한 페이지에 접근해 발생한 401 응답은 서비스에서 예상한 동작일 수 있습니다.
반면 정상적으로 로그인한 사용자에게 인증 처리의 문제로 401이 발생했다면 실제로 확인해야 하는 오류일 수 있습니다.
따라서 상태 코드나 오류 메시지만을 기준으로 일괄적으로 제외하기보다, 해당 오류가 서비스에서 예상한 동작인지 실제로 확인이 필요한 문제인지 구분하는 것이 중요합니다.
더 세밀하게 Event 제어하기
단순한 메시지 Matching보다 복잡한 조건이 필요하다면 beforeSend를 사용할 수 있습니다.
beforeSend를 이용하면 Event가 Sentry로 전송되기 전에 내용을 확인하거나 수정하고, 필요하지 않은 Event를 제거할 수도 있습니다.
import * as Sentry from '@sentry/nextjs';

Sentry.init({
  dsn: process.env.NEXT_PUBLIC_SENTRY_DSN,

  beforeSend(event) {
    if (shouldIgnoreEvent(event)) {
      return null;
    }

    return event;
  },
});
개념적으로는 다음과 같습니다.
애플리케이션에서 Error 발생
↓
Sentry Event 생성
↓
beforeSend에서 Event 확인
↓
수집할 필요가 있는 오류인가?
↓
YES → Event를 Sentry로 전송
NO  → null을 반환해 Event 제외
이를 활용하면 단순 문자열 비교보다 서비스의 상황에 맞는 Filtering 정책을 구성할 수 있습니다.
다만 Filtering 조건이 많아질수록 실제로 필요한 오류까지 제거할 가능성도 있기 때문에 가능한 한 명확한 기준을 두는 것이 좋습니다.
오류가 발생했다는 사실만으로는 부족하다
이제 중요한 오류만 수집한다고 해보겠습니다.
그런데 Sentry에 다음 정보만 들어온다면 어떨까요?
TypeError 발생
오류가 있다는 것은 알 수 있지만 원인을 찾기는 어렵습니다.
실제 문제를 분석하려면 조금 더 구체적인 정보가 필요합니다.
어떤 Error가 발생했는가?
↓
어느 코드에서 발생했는가?
↓
어떤 함수 호출을 거쳐 발생했는가?
↓
오류 객체에 추가 정보가 있었는가?
↓
오류가 발생하기 전에 어떤 동작이 있었는가?
이러한 정보를 함께 확인할 수 있어야 실제 디버깅으로 이어질 수 있습니다.
Stack Trace로 오류 발생 흐름 확인하기
Stack Trace는 오류가 발생한 위치와 그 지점까지 어떤 함수 호출이 이어졌는지를 보여줍니다.
아래 그림을 보면 Sentry의 Stack Trace에서 실제로 어떤 정보를 확인할 수 있는지 조금 더 명확하게 알 수 있습니다.
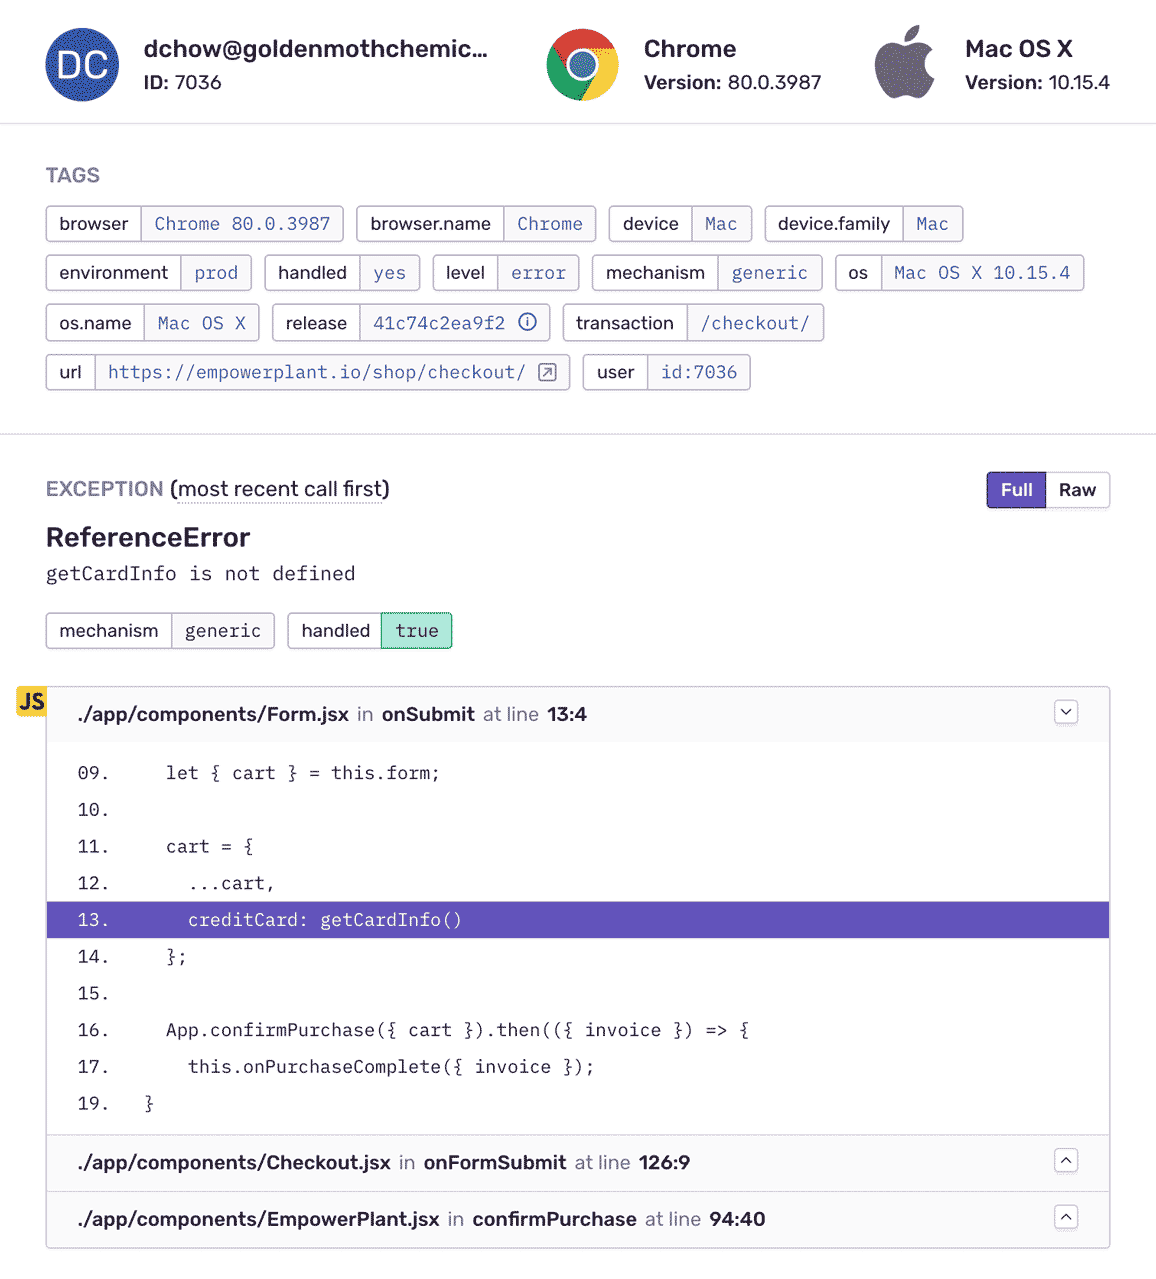
먼저 어떤 오류가 발생했는지 확인할 수 있습니다.
ReferenceError
getCardInfo is not defined
getCardInfo라는 이름을 사용했지만 정의되어 있지 않아 ReferenceError가 발생한 상황입니다.
그 아래에서는 오류가 발생한 파일과 함수, 코드 위치를 확인할 수 있습니다.
Form.jsx → onSubmit() → 13번째 줄
↓
creditCard: getCardInfo()
↓
ReferenceError 발생
Sentry는 오류가 발생한 줄을 실제 Source Code와 함께 강조해서 보여주기 때문에 어느 코드에서 문제가 발생했는지 빠르게 찾을 수 있습니다.
하지만 Stack Trace가 알려주는 것은 오류가 발생한 한 지점뿐만이 아닙니다.
그 아래의 Frame들을 보면 해당 코드까지 어떤 함수 호출을 거쳐 도달했는지도 확인할 수 있습니다.
EmpowerPlant.jsx → confirmPurchase() → 94번째 줄
↓
Checkout.jsx → onFormSubmit() → 126번째 줄
↓
Form.jsx → onSubmit() → 13번째 줄
↓
getCardInfo() 호출
↓
ReferenceError 발생
그림의 most recent call first처럼 오류가 발생한 지점에 가까운 Frame부터 확인하면서 이전 호출을 따라가면 어디에서 오류가 발생했는지뿐만 아니라 어떤 실행 흐름에서 오류가 발생했는지도 추적할 수 있습니다.
오류에 추가 정보를 함께 남기기
Stack Trace만으로 원인을 파악하기 어려운 경우도 있습니다.
예를 들어 API 요청 과정에서 오류가 발생했다고 해보겠습니다.
API 요청
↓
Error 발생
↓
Stack Trace 확인
↓
오류가 발생한 위치와 호출 흐름 확인
↓
하지만 오류 발생 당시의 요청 정보는 부족할 수 있음
예를 들어 Stack Trace만으로는
fetchUser()
↓
request()
↓
Error 발생
정도는 알 수 있지만,
요청 URL → /api/users/123
Method → GET
Status → 500
Environment → production
이럴 때 오류와 관련된 추가 Context가 있으면 문제를 파악하는 데 도움이 됩니다.
Sentry에서는 Event에 Tag, Context, Breadcrumb 등 다양한 정보를 추가할 수 있습니다.
예를 들어 특정 요청과 관련된 정보를 Context로 추가할 수 있습니다.
Sentry.setContext('request', {
  endpoint: '/api/example',
  method: 'POST',
});
또는 검색이나 분류에 활용하고 싶은 값은 Tag로 추가할 수 있습니다.
Sentry.setTag('feature', 'reservation');
개념적으로 보면 다음과 같습니다.
Error 발생
↓
Stack Trace 수집
↓
추가 Context 함께 기록
↓
어떤 기능에서 발생했는지 확인
↓
어떤 상황에서 발생했는지 확인
↓
원인 추적에 필요한 정보 확보
다만 Context에 많은 데이터를 무작정 넣는 것은 좋은 방법이 아닙니다.
전체 애플리케이션 상태처럼 큰 데이터를 전달하면 Event 크기가 커질 수 있고, 무엇보다 사용자 개인정보나 민감한 정보가 포함되지 않도록 주의해야 합니다.
따라서 오류 분석에 실제로 필요한 정보만 선택해서 전달해야 합니다.
Error 객체의 추가 정보 활용하기
JavaScript의 기본 Error 객체에서는 주로 message와 Stack Trace를 확인하게 됩니다.
하지만 API 오류처럼 디버깅에 추가 정보가 필요한 경우에는 Custom Error를 만들어 필요한 값을 함께 담을 수 있습니다.
예를 들어 다음과 같은 ApiError가 있다고 해보겠습니다.
class ApiError extends Error {
  constructor(
    message: string,
    public statusCode: number,
    public endpoint: string
  ) {
    super(message);
  }
}
이제 다음과 같이 오류를 만들 수 있습니다.
throw new ApiError('예약 요청 실패', 500, '/api/reservations');
이 Error 객체에는 기본 Error 정보뿐 아니라 서비스에서 추가한 정보도 함께 들어 있습니다.
ApiError
↓
기본 Error 정보
├─ message: "예약 요청 실패"
└─ stack: 오류 발생 위치와 호출 흐름
+
추가한 Error 정보
├─ statusCode: 500
└─ endpoint: /api/reservations
여기서 statusCode와 endpoint는 JavaScript의 기본 Error에 존재하는 속성이 아니라 서비스에서 직접 추가한 비표준 속성입니다.
Sentry JavaScript SDK에서는 extraErrorDataIntegration()을 사용해 이러한 추가 속성을 Error Event에 함께 수집할 수 있습니다.
import * as Sentry from '@sentry/nextjs';

Sentry.init({
  dsn: process.env.NEXT_PUBLIC_SENTRY_DSN,

  integrations: [Sentry.extraErrorDataIntegration()],
});
개념적으로는 다음과 같습니다.
Custom Error 발생
↓
message / stack 수집
+
statusCode / endpoint와 같은 추가 속성 확인
↓
Sentry가 Error Event에 함께 수집
↓
오류가 발생한 상황을 더 구체적으로 확인
즉 setContext()처럼 Sentry에 정보를 별도로 추가하는 방식과 달리, extraErrorDataIntegration()은 Error 객체 자체에 이미 들어 있는 추가 정보를 활용하는 방식이라고 볼 수 있습니다.
오류가 발생하기 전의 흐름도 중요하다
오류가 발생한 순간의 정보만으로도 원인을 찾기 어려운 경우가 있습니다.
예를 들어 특정 페이지에서 오류가 발생했다는 것은 알지만 사용자가 어떤 행동을 한 뒤 문제가 발생했는지는 알 수 없을 수 있습니다.
페이지 진입
↓
사용자가 특정 UI 조작
↓
API 요청
↓
페이지 이동
↓
추가 동작 수행
↓
Error 발생
이 경우 마지막 Error만 확인하는 것보다 오류가 발생하기 전 어떤 이벤트들이 있었는지 확인하면 문제를 재현하는 데 도움이 됩니다.
Sentry에서는 이러한 흐름을 Breadcrumb로 기록할 수 있습니다.
Breadcrumb에는 Navigation, HTTP Request, Console 등의 이벤트가 포함될 수 있으며 필요한 경우 직접 추가할 수도 있습니다.
예를 들어 중요한 사용자 동작을 직접 기록한다면 다음과 같이 구성할 수 있습니다.
Sentry.addBreadcrumb({
  category: 'reservation',
  message: '예약 제출',
  level: 'info',
});
그러면 오류를 단순히 하나의 순간으로 보는 것이 아니라 그 이전의 흐름과 함께 확인할 수 있습니다.
사용자가 페이지 진입
↓
Navigation / HTTP Request / 사용자 동작 발생
↓
Breadcrumb 기록
↓
Error 발생
↓
Sentry Error Event 수집
↓
Stack Trace → 오류 발생 위치와 호출 흐름
Context → 오류 발생 당시의 추가 정보
Breadcrumb → 오류 발생 전의 이벤트 흐름
↓
여러 정보를 함께 분석하여 오류 원인 추적
이렇게 오류와 함께 여러 정보를 수집하면 Production에서 직접 재현하기 어려운 문제도 조금 더 구체적으로 추적할 수 있습니다.
Production에서는 왜 Stack Trace를 읽기 어려울까?
개발 환경에서는 오류가 발생하면 우리가 작성한 파일과 코드 위치를 비교적 쉽게 확인할 수 있습니다.
하지만 Production에 배포되는 JavaScript는 우리가 작성한 TypeScript나 React 코드와 모습이 다릅니다.
Next.js의 Build 과정을 거치면서 여러 파일이 Bundle되고 코드가 변환되거나 Minify될 수 있기 때문입니다.
개발자가 작성한 원본 코드
TypeScript / React
↓
Next.js Production Build
↓
코드를 브라우저에서 실행할 수 있는 형태로 변환
↓
필요한 코드를 묶어 JavaScript Bundle 생성
↓
Minification으로 코드 크기 최소화
↓
브라우저에서 최적화된 JavaScript 실행
↓
Production에서 Error 발생
↓
변환된 JavaScript를 기준으로 Stack Trace 생성
예를 들어 개발자가 작성한 코드에서는 다음 위치에서 오류가 발생했다고 해보겠습니다.
src/components/ReservationButton.tsx
42번째 줄
하지만 Production에서는 원본 파일 구조가 아니라 Build 과정에서 생성된 JavaScript Bundle을 기준으로 오류 위치가 기록될 수 있습니다.
원본 코드
ReservationButton.tsx
42번째 줄

↓ Build

Production Bundle
chunk-abc123.js
1번째 줄의 특정 Column
이 상태에서도 오류가 발생했다는 사실은 알 수 있지만, 실제로 어떤 원본 코드에서 문제가 발생했는지 찾아가는 과정이 어려워집니다.
그래서 Production 오류를 제대로 추적하려면 변환된 JavaScript와 원본 코드를 다시 연결하는 정보가 필요합니다.
이 역할을 하는 것이 Source Map입니다.
Source Map은 무엇일까?
Source Map은 Build 과정에서 생성된 코드와 개발자가 작성한 원본 코드의 위치를 연결하기 위한 정보입니다.
개념적으로는 다음과 같습니다.
개발자가 작성한 원본 코드
src/components/ReservationButton.tsx
42번째 줄
↓
Next.js Build
↓
변환 및 Minify된 JavaScript 생성
chunk-abc123.js
↓
Source Map에 원본 코드와의 위치 관계 기록
↓
Production에서 Error 발생
chunk-abc123.js의 특정 위치
↓
Source Map을 이용해 원본 위치 탐색
↓
ReservationButton.tsx
42번째 줄
즉 Source Map이 Production 코드를 다시 원본 코드로 복원하는 것은 아닙니다.
정확하게는 변환된 코드의 특정 위치가 원본 코드의 어느 위치와 대응되는지 알려주는 Mapping 정보라고 볼 수 있습니다.
Production에서 수집한 Stack Trace와 Source Map을 연결할 수 있다면 개발자가 실제로 작성했던 코드에 가까운 형태로 오류 위치를 확인할 수 있습니다.
Source Map을 Sentry에 업로드하기
Source Map을 생성하는 것만으로는 Sentry가 자동으로 해당 파일을 알고 있는 것은 아닙니다.
Sentry에서 Production Stack Trace를 원본 코드와 연결하려면 Build 과정에서 생성된 Source Map을 Sentry가 사용할 수 있도록 업로드해야 합니다.
전체적인 흐름은 다음과 같습니다.
Next.js Production Build 시작
↓
JavaScript Bundle 생성
↓
Bundle에 대응하는 Source Map 생성
↓
Build 과정에서 Source Map을 Sentry에 업로드
↓
애플리케이션 배포
↓
Production에서 Error 발생
↓
Sentry가 Error Event 수집
↓
Stack Trace와 업로드된 Source Map 연결
↓
원본 코드 기준으로 오류 위치 확인
Next.js에서는 Sentry SDK의 Build 설정을 통해 이러한 과정을 구성할 수 있습니다.
현재 Sentry 공식 문서에서는 withSentryConfig를 사용해 Next.js 설정에 Sentry의 Build 설정을 추가할 수 있습니다.
개념적으로는 다음과 같은 구조입니다.
import { withSentryConfig } from '@sentry/nextjs';
import type { NextConfig } from 'next';

const nextConfig: NextConfig = {
  // Next.js 설정
};

export default withSentryConfig(nextConfig, {
  org: process.env.SENTRY_ORG,
  project: process.env.SENTRY_PROJECT,
  authToken: process.env.SENTRY_AUTH_TOKEN,
  silent: false,
});
실제 사용할 수 있는 옵션은 SDK 버전에 따라 달라질 수 있기 때문에 적용할 때는 Sentry의 Next.js 공식 문서를 확인하는 것이 좋습니다.
여기서 SENTRY_AUTH_TOKEN과 같은 인증 정보는 Source Map 업로드 등 Sentry와 통신해야 하는 Build 과정에서 사용됩니다.
오류를 수집하는 것만으로 충분할까?
앞에서 Sentry를 이용해 운영 환경의 Error를 수집하고 원인을 추적하기 위한 여러 방법을 살펴봤습니다.
하지만 Error를 잘 수집하고 있더라도 한 가지 문제가 남습니다.
개발자가 Sentry Dashboard를 계속 확인하고 있을 수는 없다는 점입니다.
따라서 운영 오류를 빠르게 대응하려면 오류를 수집하는 것뿐만 아니라 오류가 발생했다는 사실을 개발자가 빠르게 인지할 수 있는 구조도 필요합니다.
이를 위해 Sentry는 Slack과 같은 협업 도구와 Integration하여 Alert를 전달할 수 있습니다.
실제 운영에서도 Production 오류를 확인하기 위한 별도의 Slack 채널을 두고 Sentry Alert를 받아볼 수 있습니다.
Production에서 Error 발생
↓
Sentry가 Error Event 수집
↓
Issue 생성 및 Alert 조건 확인
↓
Slack 오류 알림 채널로 Alert 전달
↓
개발자가 오류 발생 인지
↓
Sentry Issue로 이동
↓
상세 정보 확인 및 원인 분석
이렇게 하면 개발자가 Sentry를 계속 확인하지 않더라도 평소 사용하는 협업 도구에서 운영 오류를 빠르게 발견할 수 있습니다.
Slack으로 운영 오류 빠르게 확인하기
Sentry에서는 Slack Integration을 연결하고 Alert의 알림 대상으로 특정 Slack 채널을 지정할 수 있습니다.
전체적인 구조는 다음과 같습니다.
Sentry Organization
↓
Slack Workspace 연결
↓
Alert 설정
↓
알림을 받을 Slack 채널 지정
↓
Alert 조건 충족
↓
Slack으로 Sentry 알림 전달
여기서 중요한 점은 Next.js 애플리케이션에서 Slack으로 직접 Error를 전송하는 구조는 아니라는 점입니다.
Next.js
  │
  │ Error Event
  ▼
Sentry
  │
  │ Alert
  ▼
Slack
애플리케이션은 기존처럼 Sentry SDK를 통해 Error를 전송하고, Sentry가 수집한 Issue와 Alert 조건을 기준으로 Slack에 알림을 전달합니다.
따라서 다음과 같이 애플리케이션의 Error 처리 코드마다 Slack Webhook을 직접 호출할 필요가 없습니다.
Error 발생
↓
Sentry.captureException(error)
↓
Sentry가 Event 수집 및 처리
↓
Alert 조건 충족
↓
Sentry Slack Integration
↓
지정한 Slack 채널(#sentry-errors-production)로 알림
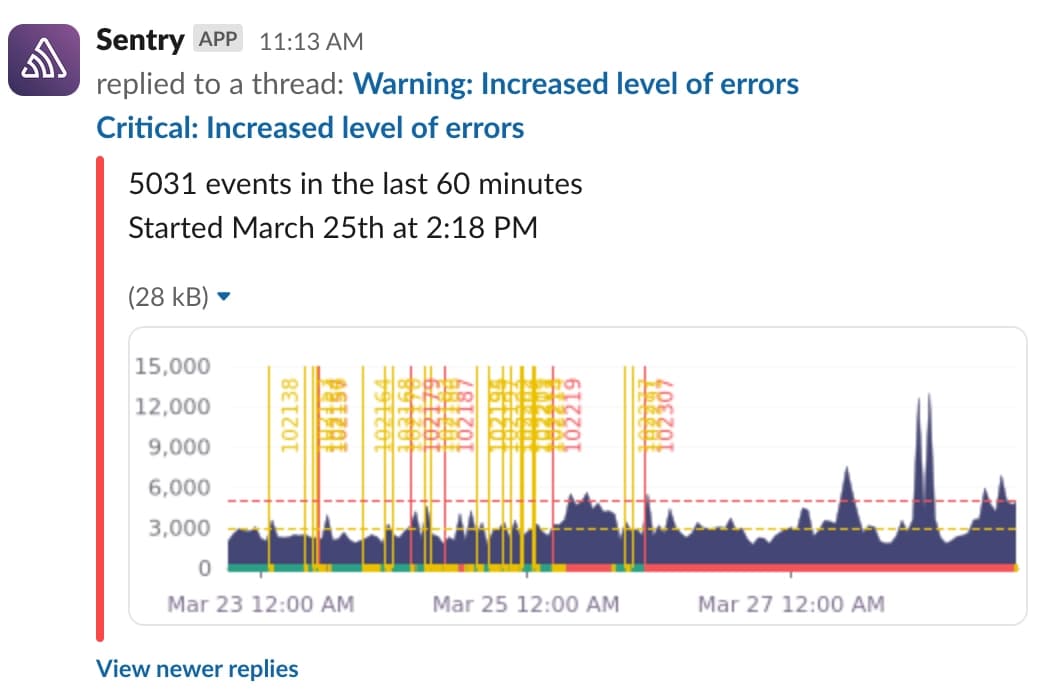
위 그림처럼 설정한 Alert 조건이 충족되면 Sentry가 지정된 Slack 채널로 알림을 전달할 수 있습니다.
예시에서는 최근 60분 동안 발생한 Event 수와 오류 증가 추이를 함께 보여주고 있습니다.
개발자는 단순히 오류가 발생했다는 사실뿐만 아니라 오류가 어느 정도 발생하고 있는지와 변화 추이도 빠르게 확인할 수 있습니다.
Slack으로 전달된 알림은 단순히 "오류가 발생했다" 는 사실만 전달하는 데 그치지 않습니다.
Sentry Issue와 연결된 알림을 통해 어떤 문제가 발생했는지 확인하고 Sentry로 이동해 더 자세한 정보를 살펴볼 수 있습니다.
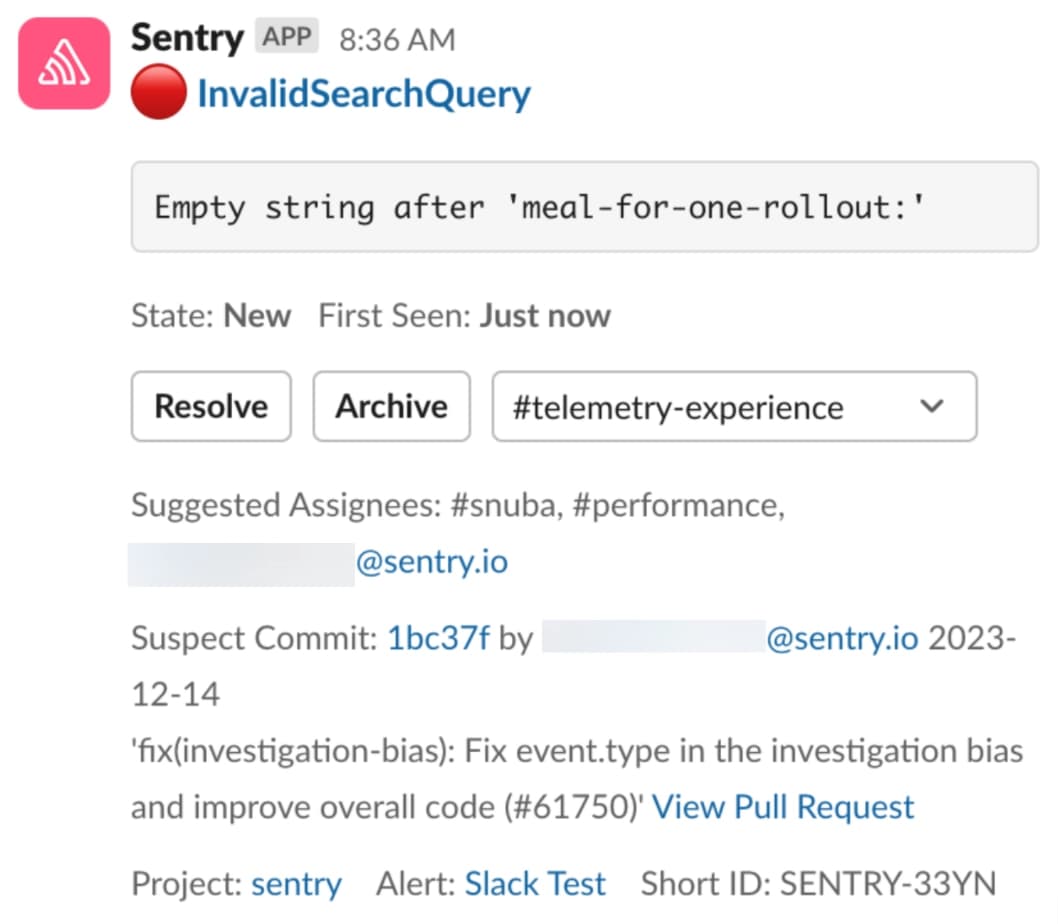
위 그림에서는 어떤 Issue가 발생했는지와 함께 Issue 상태, 최초 발생 시점, Project와 Alert 등의 Context를 확인할 수 있습니다.
또한 GitHub와 같은 Source Code 관리 도구가 연동된 환경에서는 관련 가능성이 있는 Commit이나 Pull Request 등의 정보가 함께 제공될 수 있으며, Slack에서 Issue를 Resolve하거나 Archive하는 등의 작업도 수행할 수 있습니다.
모든 Error를 알림으로 보내야 할까?
Slack 연동에서도 Error를 많이 보내는 것이 항상 좋은 것은 아닙니다.
모든 Event에 대해 알림을 발생시키면 Alert 피로가 누적되고, 그로 인해 정작 중요한 오류를 놓치게 될 수 있습니다.
따라서 앞에서 살펴본 Error Filtering과 Grouping뿐만 아니라 어떤 Issue를 실제 Alert로 전달할 것인지도 함께 고민해야 합니다.
Sentry는 Slack Integration과 Alert를 이용해 특정 Slack 채널로 알림을 전달할 수 있기 때문에 애플리케이션에서 별도의 Slack 알림 로직을 구현하지 않고도 이러한 흐름을 구성할 수 있습니다.
반대로 Sentry와 관계없는 자체 알림 시스템을 만든다면 Slack의 Incoming Webhook을 사용할 수도 있습니다.
Slack 공식 문서에서는 Slack App에 Incoming Webhook을 설정하고 발급된 URL로 JSON Payload를 전송하여 특정 채널에 메시지를 게시할 수 있도록 지원합니다.
다만 Webhook URL은 인증 정보와 마찬가지로 민감한 값이므로 Source Code에 직접 작성하지 않고 Secret이나 환경 변수 등을 통해 관리해야 합니다.
마치며
실제 서비스는 개발자가 직접 통제하기 어려운 다양한 사용자 환경에서 실행되고, 개발 과정에서는 발견하지 못했던 문제가 Production에서 처음 나타나기도 합니다.
특히 Next.js처럼 Client와 Server 양쪽에서 코드가 실행되는 환경에서는 오류가 발생할 수 있는 지점도 다양해집니다.
그래서 문제가 발생하지 않도록 만드는 것도 중요하지만, 문제가 발생했을 때 빠르게 발견하고 원인을 추적할 수 있는 구조를 만드는 것 역시 중요하다고 생각합니다.
Sentry를 적용하면서도 단순히 SDK를 설치하고 Error를 전송하는 것에서 끝나는 것이 아니라,
- 어떤 오류를 수집하고 제외할지
- 어떤 정보를 함께 남길지
- Production 코드를 어떻게 원본 코드와 연결할지
- 발생한 오류를 개발자가 어떻게 빠르게 인지할지
까지 함께 고민해야 했습니다.
결국 오류 모니터링은 다음과 같은 하나의 흐름을 만드는 작업입니다.
실제 사용자 환경에서 문제 발생
↓
Sentry에서 오류 수집
↓
불필요한 Noise Filtering
↓
유사한 오류를 Issue로 Grouping
↓
Alert 조건에 따라 Slack으로 오류 알림
↓
개발자가 운영 오류 발생 인지
↓
Sentry Issue에서 오류가 발생한 환경과 흐름 확인
↓
Stack Trace, Context, Breadcrumb 확인
↓
Source Map을 통해 원본 코드 위치 추적
↓
원인 파악 및 문제 수정
↓
수정된 코드를 다시 서비스에 반영
운영 환경에서 발생할 수 있는 모든 오류를 미리 막는 것은 어렵습니다.
다만 오류가 발생했을 때 얼마나 빠르게 인지하고, 원인을 파악하고, 대응할 수 있는가 역시 서비스의 안정성을 결정짓는 중요한 요소라고 생각합니다.