- Published on
Next.js에서 SEO를 설계하며 고려한 것들 - Part 1
- Authors
- Name
- GW
개요
웹 서비스를 개발하다 보면 검색을 통한 사용자 유입이 중요한 경우가 있습니다.
이때 가장 먼저 떠올리는 것이 SEO(Search Engine Optimization) 입니다.
SEO라고 하면 흔히 다음과 같은 작업을 생각하기 쉽습니다.
<title>페이지 제목</title>

<meta name="description" content="페이지 설명" />
물론 이러한 Metadata도 중요합니다.
하지만 실제 SEO는 단순히 title과 description을 추가하는 것보다 훨씬 넓은 범위를 다룹니다.
검색 엔진이 페이지를 검색 결과에 보여주기 위해서는 먼저 페이지를 발견하고, 콘텐츠를 가져오고, 그 내용을 이해할 수 있어야 합니다.
그리고 이 과정에는 페이지가 어떤 방식으로 렌더링되는지, 검색 엔진에게 어떤 HTML을 제공하는지도 영향을 줄 수 있습니다.
특히 React와 같은 JavaScript 기반 애플리케이션에서는 이러한 렌더링 방식을 함께 이해하는 것이 중요합니다.
이번 글에서는 아래와 같은 내용을 하나씩 살펴보며 Next.js에서 SEO를 설계할 때 고려해야 할 요소들을 알아보겠습니다.
- 검색 엔진의 Crawling, Rendering, Indexing 과정
- CSR과 Server Rendering의 SEO 차이
- Semantic HTML과 Metadata를 활용한 페이지 정보 구성
- Canonical URL과 JSON-LD를 활용한 콘텐츠 구조화
검색 엔진은 페이지를 어떻게 처리할까?
SEO를 이해하려면 먼저 검색 엔진이 웹 페이지를 어떻게 처리하는지 알아야 합니다.
Google Search Central에서는 JavaScript 기반 페이지가 검색에 반영되는 과정을 Crawling, Rendering, Indexing 등의 단계로 설명합니다.
*Google Search Central - JavaScript SEO basics
조금 단순하게 표현하면 다음과 같습니다.
Crawling
↓
Rendering
↓
Indexing
각 단계가 어떤 역할을 하는지 살펴보겠습니다.
Crawling
첫 번째는 Crawling(크롤링) 입니다.
Google과 같은 검색 엔진은 Googlebot과 같은 크롤러를 이용해 웹 페이지를 탐색합니다.
크롤러는 발견한 URL에 HTTP 요청을 보내고 서버가 반환한 응답을 가져옵니다.
Googlebot
↓
URL 발견
↓
HTTP Request
↓
Server
↓
HTML Response
그리고 페이지에 포함된 링크 등을 확인하면서 새로운 URL을 발견하고 크롤링 대상을 확장해 나갈 수 있습니다.
즉, Crawling은 쉽게 말하면
검색 엔진이 페이지를 발견하고 가져오는 과정
이라고 이해할 수 있습니다.
다만 URL이 발견되었다고 해서 반드시 크롤링되는 것은 아닙니다.
예를 들어 robots.txt를 통해 특정 경로의 크롤링을 제한할 수 있습니다.
robots.txt와 Sitemap에 대해서는 뒤에서 자세히 살펴보겠습니다.
Rendering
JavaScript 기반 웹 애플리케이션에서는 Crawling 이후 Rendering(렌더링) 과정도 중요합니다.
과거에는
React처럼 JavaScript로 만들어진 페이지는 Google이 읽을 수 없다.
라는 설명을 종종 볼 수 있었습니다.
하지만 현재 Google Search에 대해서는 정확한 설명이 아닙니다.
Google은 Web Rendering Service를 통해 JavaScript를 실행하고 페이지를 렌더링할 수 있습니다.
즉, 초기 HTML에 실제 콘텐츠가 충분히 포함되어 있지 않더라도 JavaScript 실행 이후 생성된 콘텐츠를 Google이 처리할 수 있습니다.
예를 들어 CSR 기반 애플리케이션의 초기 HTML이 다음과 같다고 해보겠습니다.
<html>
  <body>
    <div id="root"></div>
    <script src="/app.js"></script>
  </body>
</html>
이 HTML만 보면 실제 페이지의 주요 콘텐츠는 존재하지 않습니다.
JavaScript가 실행된 이후에야 화면에 필요한 콘텐츠가 만들어질 수 있습니다.
HTML Response
↓
JavaScript 다운로드
↓
JavaScript 실행
↓
필요한 데이터 요청
↓
DOM 업데이트
↓
페이지 콘텐츠 완성
Google 역시 JavaScript를 렌더링하여 이렇게 만들어진 콘텐츠를 처리할 수 있습니다.
따라서 다음과 같이 이해하는 것은 정확하지 않습니다.
CSR
↓
검색 엔진이 콘텐츠를 볼 수 없음
보다 정확하게는 다음과 같이 이해하는 것이 좋습니다.
CSR
↓
초기 HTML에 주요 콘텐츠가 없을 수 있음
↓
JavaScript 실행
↓
콘텐츠 렌더링
↓
검색 엔진이 렌더링된 콘텐츠 처리
Indexing
검색 엔진은 가져오고 렌더링한 페이지를 분석하여 검색 색인에 저장할 수 있습니다.
이 과정을 Indexing(색인 생성) 이라고 합니다.
Google은 페이지의 텍스트뿐 아니라 <title>과 같은 주요 태그와 속성, 이미지와 비디오 등의 정보도 분석하여 페이지가 무엇에 관한 것인지 파악합니다.
*Google Search Central - How Google Search Works
전체 흐름을 조금 단순하게 정리하면 다음과 같습니다.
Crawling (페이지 발견 및 가져오기)
↓
Rendering (JavaScript 실행 및 콘텐츠 확인)
↓
Indexing (콘텐츠 분석 및 검색 색인에 저장)
여기서 중요한 점이 하나 있습니다.
Crawling되었다고 해서 반드시 Indexing되는 것은 아닙니다.
검색 엔진이 페이지를 가져갔다고 해서 모든 페이지가 검색 결과에 등록되는 것은 아닙니다.
따라서 SEO는 단순히 검색 엔진이 URL을 발견하게 만드는 것만으로 끝나지 않습니다.
그렇다면 CSR은 SEO에 불리할까?
여기까지 보면 한 가지 의문이 생깁니다.
Google이 JavaScript를 실행할 수 있다면 굳이 서버에서 HTML을 생성할 필요가 있을까요?
먼저 분명히 해야 할 것은
CSR이라고 해서 SEO가 불가능한 것은 아닙니다.
Google Search는 JavaScript를 실행할 수 있으며 JavaScript로 생성된 콘텐츠도 처리할 수 있습니다.
하지만 CSR과 서버에서 콘텐츠가 포함된 HTML을 제공하는 방식에는 검색 엔진이 콘텐츠를 확인하는 과정에서 차이가 있습니다.
CSR에서는 다음과 같은 과정이 필요할 수 있습니다.
Request
↓
HTML Response
↓
JavaScript 다운로드
↓
JavaScript 실행
↓
필요한 데이터 요청
↓
콘텐츠 생성
↓
검색 엔진이 렌더링된 콘텐츠 확인
반면 서버에서 주요 콘텐츠가 포함된 HTML을 생성하면 다음과 같이 볼 수 있습니다.
Request
↓
Server에서 콘텐츠 생성
↓
콘텐츠가 포함된 HTML Response
↓
검색 엔진이 HTML에서 주요 콘텐츠 확인
즉, 핵심적인 차이 중 하나는 검색 엔진에게 전달되는 초기 HTML에 주요 콘텐츠가 포함되어 있는가입니다.
Google 공식 문서에서도 Server-side Rendering이나 Pre-rendering은 여전히 좋은 방법이라고 설명합니다.
특히 서버에서 HTML을 생성하면 사용자와 크롤러가 콘텐츠를 더 빠르게 확인할 수 있고, 모든 검색 봇이 JavaScript를 실행하는 것도 아니기 때문입니다.
*Google Search Central - Dynamic Rendering
따라서
CSR = SEO 불가능
SSR = SEO 가능
처럼 이분법적으로 이해하기보다는
CSR
→ JavaScript 실행 이후 주요 콘텐츠가 완성될 수 있음

Server Rendering / Pre-rendering
→ 주요 콘텐츠가 포함된 HTML을 제공할 수 있음
이라는 차이로 이해하는 것이 더 정확합니다.
SSR은 어떻게 동작할까?
SSR(Server-Side Rendering)은 요청을 받은 서버가 페이지를 렌더링하여 HTML을 만들어 응답하는 방식입니다.
개념적으로 보면 다음과 같습니다.
브라우저, 검색 엔진 (페이지 요청)
↓
서버 (데이터 조회 + HTML 생성)
↓
브라우저 응답 (완성된 HTML 전달)
예를 들어 상품 상세 페이지가 있다고 가정해 보겠습니다.
type ProductPageProps = {
  params: Promise<{
    id: string;
  }>;
};

const ProductPage = async ({ params }: ProductPageProps) => {
  const { id } = await params;
  const product = await getProduct(id);

  return (
    <main>
      <h1>{product.name}</h1>
      <p>{product.description}</p>
      <strong>{product.price.toLocaleString()}원</strong>
    </main>
  );
};

export default ProductPage;
서버에서 데이터를 가져와 HTML을 생성한다면 검색 엔진은 응답받은 HTML에서 주요 콘텐츠를 확인할 수 있습니다.
개념적으로 다음과 같은 HTML이 전달될 수 있습니다.
<main>
  <h1>상품 이름</h1>
  <p>상품에 대한 설명입니다.</p>
  <strong>30,000원</strong>
</main>
검색 엔진 입장에서는 주요 콘텐츠가 HTML 응답에 이미 포함되어 있습니다.
이것이 Server Rendering이나 Pre-rendering이 SEO와 함께 자주 언급되는 중요한 이유 중 하나입니다.
Next.js에서는 모든 페이지를 SSR로 만들어야 할까?
그렇지는 않습니다.
여기서 SSR과 서버에서 HTML을 미리 생성하는 방식을 모두 같은 의미로 생각하지 않는 것이 중요합니다.
SEO 관점에서 중요한 것은 반드시
모든 요청마다 서버에서 HTML을 새로 만들어야 한다.
는 것이 아닙니다.
페이지 특성에 따라 정적으로 미리 생성된 HTML을 제공하는 것도 좋은 방법이 될 수 있습니다.
예를 들어 콘텐츠가 자주 변경되지 않는 페이지라면 요청마다 서버에서 동일한 결과를 다시 생성할 필요가 없습니다.
변경이 적은 콘텐츠
↓
미리 HTML 생성
↓
Request
↓
생성된 결과 제공
반대로 요청에 따라 데이터가 달라지거나 항상 최신 정보가 필요한 페이지라면 요청 시점에 서버에서 처리해야 할 수도 있습니다.
Request
↓
최신 데이터 조회
↓
페이지 렌더링
↓
Response
즉, SEO 때문에 무조건 SSR을 선택하는 것이 아니라 콘텐츠의 특성과 변경 주기에 적합한 렌더링 전략을 선택하는 것이 중요합니다.
Next.js App Router에서는 Server Component를 기본으로 사용하며, 데이터 캐싱과 Dynamic API 사용 여부 등에 따라 정적 또는 동적인 렌더링 전략을 구성할 수 있습니다.
따라서
SEO가 중요함
↓
무조건 SSR
이 아니라
페이지 특성 파악
↓
콘텐츠 변경 주기 확인
↓
사용자별 데이터 여부 확인
↓
적절한 Rendering Strategy 선택
으로 접근하는 것이 좋습니다.
SSR을 사용하면 SEO가 해결될까?
여기서 가장 주의해야 할 부분이 있습니다.
SSR을 적용했다고 해서 SEO가 자동으로 해결되는 것은 아닙니다.
SSR은 검색 엔진에게 주요 콘텐츠가 포함된 HTML을 제공할 수 있는 렌더링 전략 중 하나입니다.
하지만 검색 엔진이 페이지를 발견하고 내용을 이해하는 과정에서는 그 외에도 여러 요소를 함께 고려해야 합니다.
예를 들어 서버에서 다음 HTML을 제공한다고 생각해 보겠습니다.
<div>
  <div>상품 이름</div>
  <div>상품 설명</div>
  <div>30000</div>
</div>
검색 엔진은 콘텐츠 자체를 확인할 수 있습니다.
하지만 조금 더 의미가 드러나는 HTML 구조로 작성할 수도 있습니다.
<main>
  <article>
    <h1>상품 이름</h1>
    <p>상품 설명</p>
    <strong>30,000원</strong>
  </article>
</main>
여기에 페이지의 Metadata도 추가할 수 있습니다.
<title>상품 이름 | Example</title>

<meta name="description" content="상품에 대한 설명입니다." />
그리고 콘텐츠의 의미를 구조적인 형태로 검색 엔진에 전달하기 위해 JSON-LD와 같은 Structured Data를 사용할 수도 있습니다.
즉, SEO를 위해 고려해야 할 요소는 렌더링 방식 하나로 끝나지 않습니다.
- Rendering Strategy → 콘텐츠를 어떤 방식으로 제공할 것인가?
- Semantic HTML → 문서 구조와 의미를 어떻게 표현할 것인가?
- Metadata → 페이지의 정보를 어떻게 설명할 것인가?
- Structured Data → 콘텐츠의 의미를 어떻게 구조적으로 전달할 것인가?
- Canonical → 대표 URL에 대한 신호를 어떻게 제공할 것인가?
- Sitemap → 검색 엔진의 URL 발견을 어떻게 도울 것인가?
- Robots → 크롤링 정책을 어떻게 관리할 것인가?
결국 SSR은 이 전체 과정 중 콘텐츠를 검색 엔진에게 어떤 방식으로 제공할 것인가와 관련된 하나의 요소라고 볼 수 있습니다.
Next.js가 SEO를 자동으로 해결해주는 것은 아니다
Next.js에는 SEO를 구현하는 데 활용할 수 있는 여러 기능이 존재합니다.
예를 들어 App Router에서는 정적인 metadata 객체와 동적인 generateMetadata를 통해 Metadata를 정의할 수 있습니다.
Next.js는 이를 기반으로 적절한 <head> 요소를 생성합니다.
*Next.js - Metadata and OG images
또한 다음과 같은 Metadata File Convention도 제공합니다.
robots.ts
sitemap.ts
opengraph-image.tsx
icon.tsx
...
하지만 Next.js가 이러한 기능을 제공한다고 해서 검색 엔진 최적화가 자동으로 이루어지는 것은 아닙니다.
개발자는 여전히 다음과 같은 문제를 고려해야 합니다.
- 검색 엔진은 이 페이지를 발견할 수 있는가?
- 핵심 콘텐츠를 확인할 수 있는가?
- 페이지의 의미를 이해할 수 있는가?
- 어떤 URL을 대표 URL로 사용해야 하는가?
- 어떤 페이지의 크롤링을 허용할 것인가?
즉, Next.js는 SEO를 자동으로 해결해주는 프레임워크라기보다 SEO에 필요한 여러 요소를 구현할 수 있는 기능을 제공하는 프레임워크라고 보는 것이 더 정확합니다.
검색 엔진이 콘텐츠를 이해하도록 만들기
앞에서는 검색 엔진이 페이지를 처리하는 과정과 Next.js의 렌더링 전략을 살펴봤습니다.
서버에서 주요 콘텐츠가 포함된 HTML을 제공하면 검색 엔진이 페이지의 콘텐츠를 확인하는 데 도움을 줄 수 있습니다.
하지만 콘텐츠를 전달하는 것만으로 끝나는 것은 아닙니다.
검색 엔진이 해당 페이지가 무엇을 다루고 있는지 이해할 수 있도록 적절한 정보를 제공하는 것도 중요합니다.
이를 위해 여러 요소를 함께 고려할 수 있습니다.
- Semantic HTML → 문서의 구조와 의미 표현
- Metadata → 페이지에 대한 정보 제공
- Canonical → 대표 URL에 대한 신호 제공
- Structured Data → 콘텐츠의 의미를 구조화된 데이터로 제공
하나씩 살펴보겠습니다.
Semantic HTML로 문서의 의미 표현하기
HTML을 작성할 때 모든 요소를 div로 만들 수도 있습니다.
예를 들어 다음과 같은 상품 페이지가 있다고 해보겠습니다.
<div>
  <div>무선 키보드</div>
  <div>편안한 타이핑을 위한 무선 키보드입니다.</div>

  <div>
    <div>제품 특징</div>
    <div>Bluetooth 연결을 지원합니다.</div>
  </div>
</div>
브라우저에서 CSS를 적용하면 사용자에게는 충분히 정상적인 화면으로 보일 수 있습니다.
하지만 HTML만 보면 각각의 요소가 어떤 역할을 하는지 명확하게 드러나지 않습니다.
이를 의미에 맞는 HTML 요소로 표현하면 다음과 같이 작성할 수 있습니다.
<main>
  <article>
    <h1>무선 키보드</h1>

    <p>편안한 타이핑을 위한 무선 키보드입니다.</p>

    <section>
      <h2>제품 특징</h2>
      <p>Bluetooth 연결을 지원합니다.</p>
    </section>
  </article>
</main>
이제 HTML 자체에 문서의 구조가 드러납니다.
- main → 페이지의 주요 콘텐츠
- article → 독립적인 콘텐츠
- h1 → 페이지의 주요 제목
- section → 콘텐츠의 논리적인 영역
- h2 → 해당 영역의 제목
이처럼 HTML 요소를 단순히 화면을 구성하기 위한 박스로만 사용하는 것이 아니라 각 요소가 가진 의미에 맞게 사용하는 방식을 Semantic HTML이라고 합니다.
Semantic HTML은 검색 엔진만을 위한 기술은 아닙니다.
브라우저와 검색 엔진뿐 아니라 스크린 리더와 같은 보조 기술이 문서 구조를 이해하는 데에도 도움이 됩니다.
특정 Semantic HTML 요소를 사용했다는 이유만으로 검색 순위가 올라간다고 단정할 수는 없습니다.
더 중요한 것은 문서의 실제 콘텐츠와 구조를 HTML에서도 명확하고 일관되게 표현하는 것입니다.
예를 들어 페이지의 핵심 제목이라면 단순히 큰 글씨의 div를 만드는 것보다 적절한 heading을 사용하는 것이 문서 구조를 표현하는 데 더 적합합니다.
<!-- 의미보다 표현에 집중한 구조 -→
<div class="title">무선 키보드</div>

<!-- 문서의 주요 제목이라는 의미까지 표현 -→
<h1>무선 키보드</h1>
SEO를 위해 Semantic HTML을 사용한다기보다,
HTML을 본래 의미에 맞게 작성하면 접근성, 유지보수성뿐 아니라 검색 엔진이 문서를 이해할 때 활용할 수 있는 구조도 함께 명확해진다
라고 이해하는 것이 좋습니다.
Metadata로 페이지에 대한 정보 제공하기
Semantic HTML이 본문의 구조와 의미를 표현한다면 Metadata는 페이지 자체에 대한 정보를 제공합니다.
대표적으로 다음과 같은 정보가 있습니다.
<title>무선 키보드 | Example</title>

<meta name="description" content="편안한 타이핑을 위한 무선 키보드를 확인해보세요." />
title은 페이지의 제목을 나타내고 description은 페이지의 내용을 설명합니다.
Google 역시 JavaScript SEO 가이드에서 페이지마다 고유하고 설명적인 title과 meta description을 사용하는 것을 권장하고 있습니다.
Metadata는 일반적으로 화면의 본문에 직접 표시되지는 않지만 검색 엔진이나 소셜 미디어와 같은 시스템이 페이지 정보를 이해하는 데 활용할 수 있습니다.
Next.js App Router에서는 Metadata API를 이용해 이러한 정보를 선언할 수 있습니다.
*Next.js - Metadata and OG images
예를 들어 정적인 페이지라면 다음과 같이 작성할 수 있습니다.
import type { Metadata } from 'next';

export const metadata: Metadata = {
  title: '상품 목록 | Example',
  description: '다양한 상품을 확인해보세요.',
};

const ProductsPage = () => {
  return (
    <main>
      <h1>상품 목록</h1>
    </main>
  );
};

export default ProductsPage;
Next.js는 이 Metadata를 기반으로 필요한 <head> 요소를 생성합니다.
개념적으로는 다음과 같은 HTML 정보가 만들어집니다.
<head>
  <title>상품 목록 | Example</title>
  <meta name="description" content="다양한 상품을 확인해보세요." />
</head>
이 방식은 모든 페이지의 정보가 동일한 정적 페이지에서는 간단합니다.
하지만 실제 서비스에는 동적인 페이지가 많습니다.
/products/1
/products/2
/products/3
...
각 페이지의 콘텐츠가 다른데 모든 페이지에 동일한 Metadata를 사용한다면 페이지의 실제 내용을 충분히 설명하기 어렵습니다.
이럴 때 generateMetadata를 사용할 수 있습니다.
동적 페이지에서는 Metadata도 달라져야 한다
상품 상세 페이지를 예로 들어보겠습니다.
다음과 같이 각각 다른 상품이 존재한다고 가정하겠습니다.
/products/1
→ 무선 키보드

/products/2
→ 무선 마우스

/products/3
→ 모니터
페이지의 실제 콘텐츠는 다르지만 모든 페이지가 다음 Metadata를 사용한다면 어떨까요?
<title>상품 상세 | Example</title>

<meta name="description" content="상품 정보를 확인해보세요." />
페이지마다 어떤 상품을 다루고 있는지 Metadata만으로는 명확하게 구분하기 어렵습니다.
Google도 페이지마다 고유하고 설명적인 제목을 제공할 것을 권장합니다.
따라서 동적 페이지에서는 실제 콘텐츠에 맞춰 Metadata 역시 동적으로 생성하는 것이 좋습니다.
Next.js에서는 generateMetadata를 사용할 수 있습니다.
import type { Metadata } from 'next';

type ProductPageProps = {
  params: Promise<{
    id: string;
  }>;
};

export const generateMetadata = async ({ params }: ProductPageProps): Promise<Metadata> => {
  const { id } = await params;
  const product = await getProduct(id);

  return {
    title: `${product.name} | Example`,
    description: product.description,
  };
};

const ProductPage = async ({ params }: ProductPageProps) => {
  const { id } = await params;
  const product = await getProduct(id);

  return (
    <main>
      <h1>{product.name}</h1>
      <p>{product.description}</p>
    </main>
  );
};

export default ProductPage;
이제 페이지 데이터에 따라 Metadata도 달라집니다.
/products/1 (무선 키보드 데이터)
↓
generateMetadata (무선 키보드 | Example)

/products/2 (무선 마우스 데이터)
↓
generateMetadata (무선 마우스 | Example)
즉, 페이지 콘텐츠와 Metadata를 같은 데이터에 기반해 생성할 수 있습니다.
이 구조의 중요한 점은 사용자에게 보여주는 콘텐츠와 검색 엔진에 제공하는 페이지 정보가 서로 일치하도록 관리할 수 있다는 것입니다.
Server Data
↓
┌─────────────────────┐
│                     │
▼                     ▼
Page Content      Metadata
│                     │
▼                     ▼
사용자에게 표시     페이지 정보 제공
Next.js의 metadata와 generateMetadata는 Server Component에서 사용할 수 있습니다.
또한 상위 Layout의 Metadata를 하위 페이지가 상속하거나 덮어쓸 수 있기 때문에 공통 Metadata와 페이지별 Metadata를 나누어 관리할 수도 있습니다.
예를 들어 Root Layout에서는 공통적인 title template을 설정할 수 있습니다.
import type { Metadata } from 'next';

export const metadata: Metadata = {
  title: {
    default: 'Example',
    template: '%s | Example',
  },
  description: 'Example 서비스입니다.',
};
그리고 각각의 페이지에서는 페이지에 필요한 제목만 정의할 수 있습니다.
export const metadata: Metadata = {
  title: '상품 목록',
};
그러면 최종 제목은 다음과 같이 구성됩니다.
상품 목록
+
%s | Example
↓
상품 목록 | Example
서비스 규모가 커질수록 이런 방식으로 사이트 공통 Metadata와 페이지별 Metadata의 책임을 분리하는 것도 중요합니다.
Open Graph와 SEO Metadata는 같은 것일까?
Metadata를 다루다 보면 Open Graph도 함께 설정하는 경우가 많습니다.
예를 들어 Next.js에서는 다음과 같이 작성할 수 있습니다.
export const metadata: Metadata = {
  title: '무선 키보드 | Example',
  description: '편안한 타이핑을 위한 무선 키보드입니다.',

  openGraph: {
    title: '무선 키보드',
    description: '편안한 타이핑을 위한 무선 키보드입니다.',
    images: ['/images/keyboard.png'],
  },
};
하지만 일반적인 SEO Metadata와 Open Graph의 목적은 완전히 같지 않습니다.
title / description (페이지에 대한 Metadata)
↓
검색 엔진 등이 활용

Open Graph (페이지 공유 정보)
↓
SNS / 메신저 등의 미리보기에서 활용
따라서 Open Graph를 설정했다고 검색 엔진용 Metadata 설정이 모두 끝났다고 생각하기보다는 각각의 목적을 구분해서 관리하는 것이 좋습니다.
Canonical URL은 왜 필요할까?
웹 서비스를 운영하다 보면 동일하거나 매우 유사한 콘텐츠가 여러 URL을 통해 접근 가능한 경우가 있습니다.
예를 들어 다음 URL들이 있다고 가정해 보겠습니다.
https://example.com/products/1
https://example.com/products/1?ref=home
https://example.com/products/1?utm_source=example
URL은 서로 다르지만 실제로 보여주는 핵심 콘텐츠는 동일할 수 있습니다.
이런 상황에서 검색 엔진은 여러 URL 중 어떤 URL을 대표 URL로 볼지 판단해야 합니다.
이때 사용할 수 있는 것이 Canonical URL 입니다.
HTML에서는 다음과 같이 표현합니다.
<link rel="canonical" href="https://example.com/products/1" />
이는 검색 엔진에게
이 콘텐츠의 대표 URL로 이 URL을 선호합니다.
라는 신호를 제공하는 것입니다.
여기서 중요한 점이 있습니다.
Canonical은 Redirect가 아닙니다.
- Redirect → 사용자의 요청 자체를 다른 URL로 이동
- Canonical → 현재 페이지는 그대로 접근 가능 (검색 엔진에게 선호하는 대표 URL에 대한 신호 제공)
그리고 Canonical을 설정했다고 Google이 반드시 해당 URL을 대표 URL로 선택하는 것도 아닙니다.
Google은 rel="canonical"을 강한 신호로 사용하지만 다른 여러 신호를 함께 고려하여 최종 Canonical URL을 결정합니다.
*Google Search Central - Canonical URL
Next.js에서는 Metadata API의 alternates.canonical을 이용할 수 있습니다.
import type { Metadata } from 'next';

export const metadata: Metadata = {
  alternates: {
    canonical: 'https://example.com/products',
  },
};
동적 페이지라면 다음과 같이 페이지별 Canonical URL을 생성할 수도 있습니다.
export const generateMetadata = async ({ params }: ProductPageProps): Promise<Metadata> => {
  const { id } = await params;
  const product = await getProduct(id);

  return {
    title: product.name,
    description: product.description,

    alternates: {
      canonical: `https://example.com/products/${id}`,
    },
  };
};
이렇게 하면 query parameter 등으로 동일한 콘텐츠에 접근할 수 있더라도 대표 URL에 대한 신호를 명시적으로 제공할 수 있습니다.
Google은 Canonical을 지정할 때 상대 경로보다 절대 URL을 사용하는 것을 권장합니다.
- 권장 →
https://example.com/products/1 - 비권장 →
/products/1
또 Canonical 페이지 자체에도 자기 자신을 가리키는 Self-referencing Canonical을 사용하는 것을 권장합니다.
즉,
/products/1 페이지 안에
↓
<link rel="canonical" href="https://example.com/products/1" />
↓
자기 자신을 가리킴
처럼 대표 페이지에서도 자신의 대표 URL을 명시할 수 있습니다.
Structured Data는 왜 필요할까?
여기까지 다음과 같은 정보를 제공했습니다.
Semantic HTML → 문서의 구조와 의미
Metadata → 페이지에 대한 정보
Canonical → 대표 URL에 대한 신호
그런데 검색 엔진에게 콘텐츠의 의미를 조금 더 구조화된 형태로 전달하고 싶다면 어떻게 해야 할까요?
이때 사용할 수 있는 것이 Structured Data(구조화 데이터) 입니다.
예를 들어 화면에 다음과 같은 정보가 있다고 해보겠습니다.
<h1>무선 키보드</h1>
<p>가격: 30,000원</p>
<p>평점: 4.8</p>
사람은 이 내용을 보고 쉽게 이해할 수 있습니다.
무선 키보드 → 상품명
30,000원 → 가격
4.8 → 평점
하지만 이러한 의미를 검색 엔진에게 더 명시적인 데이터 구조로 제공할 수도 있습니다.
예를 들어 다음과 같습니다.
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "무선 키보드",
  "description": "편안한 타이핑을 위한 무선 키보드입니다."
}
이제 단순한 문자열이 아니라 각각의 데이터가 어떤 의미를 가지는지 명시적으로 표현됩니다.
@type → 이 데이터는 Product
name → 상품 이름
description → 상품 설명
이것이 Structured Data를 사용하는 중요한 이유입니다.
Google 역시 Structured Data를 페이지에 대한 명시적인 단서를 제공하여 페이지의 의미를 이해하는 데 도움을 주는 표준화된 형식으로 설명합니다.
*Google Search Central - Structured Data
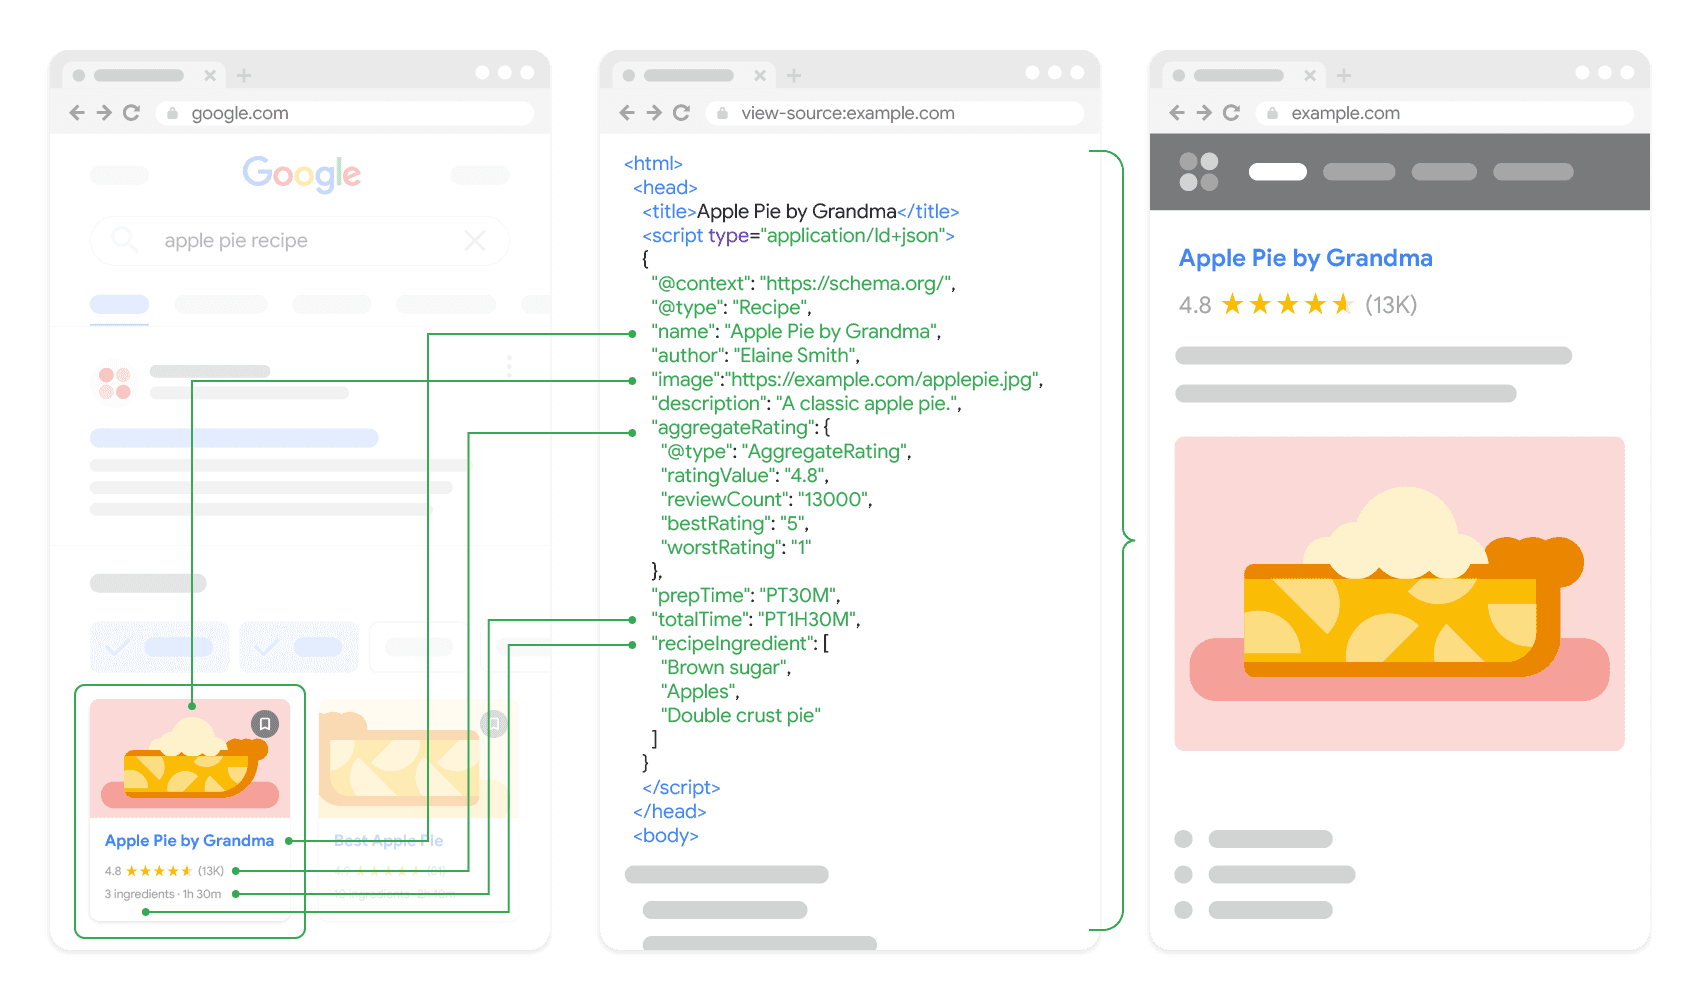
JSON-LD는 무엇일까?
Structured Data를 HTML에 표현하는 방법은 하나만 있는 것이 아닙니다.
대표적으로 다음과 같은 형식이 있습니다.
- JSON-LD
- Microdata
- RDFa
Google은 일반적으로 JSON-LD 사용을 권장합니다.
JSON-LD는 JavaScript Object 형태와 유사한 JSON 문법을 이용해 Structured Data를 표현하는 방식입니다.
HTML 요소마다 속성을 추가하는 대신 별도의 <script> 요소에 구조화된 데이터를 작성할 수 있습니다.
<script type="application/ld+json">
  {
    "@context": "https://schema.org",
    "@type": "Product",
    "name": "무선 키보드",
    "description": "편안한 타이핑을 위한 무선 키보드입니다."
  }
</script>
여기서 중요한 것은 일반적인 JavaScript 코드가 아니라는 점입니다.
type="application/ld+json"
을 사용하여 해당 데이터가 JSON-LD 형식의 Linked Data라는 것을 나타냅니다.
HTML과 JSON-LD의 역할을 비교하면 다음과 같습니다.
HTML
↓
실제 페이지 콘텐츠와 문서 구조 표현

JSON-LD
↓
페이지 콘텐츠의 의미를 구조화된 데이터로 표현
둘 중 하나를 선택하는 것이 아닙니다.
실제 페이지에는 사용자가 볼 수 있는 콘텐츠가 존재하고, JSON-LD는 그 콘텐츠의 의미를 검색 엔진이 이해하기 쉬운 구조로 추가 설명하는 역할을 할 수 있습니다.
Next.js에서 JSON-LD 적용하기
Next.js 공식 문서에서는 layout이나 page에서 <script> 요소를 렌더링하여 JSON-LD를 제공하는 방법을 설명하고 있습니다.
예를 들어 다음과 같이 작성할 수 있습니다.
const ProductPage = async ({ params }: ProductPageProps) => {
  const { id } = await params;
  const product = await getProduct(id);

  const jsonLd = {
    '@context': 'https://schema.org',
    '@type': 'Product',
    name: product.name,
    description: product.description,
  };

  return (
    <>
      <script
        type="application/ld+json"
        dangerouslySetInnerHTML={{
          __html: JSON.stringify(jsonLd).replace(/</g, '\\u003c'),
        }}
      />

      <main>
        <h1>{product.name}</h1>
        <p>{product.description}</p>
      </main>
    </>
  );
};

export default ProductPage;
여기서 눈에 띄는 코드가 있습니다.
JSON.stringify(jsonLd).replace(/</g, '\\u003c');
단순히 다음과 같이 작성하지 않았습니다.
JSON.stringify(jsonLd);
왜 < 문자를 변환하는 걸까요?
Next.js 공식 문서에서는 JSON.stringify 자체가 JSON-LD에 포함될 수 있는 악의적인 문자열을 자동으로 제거해주지 않는다는 점을 주의사항으로 설명합니다.
예를 들어 외부 데이터에 HTML의 </script>와 같은 문자열이 포함될 가능성을 고려해야 합니다.
따라서 < 문자를 Unicode escape sequence인 \u003c로 변환하여 이러한 위험을 줄일 수 있습니다.
Server Data로 JSON-LD 객체 생성
↓
JSON.stringify로 문자열 변환
↓
문자열 내 < 를 \u003c로 치환 (위험한 문자 처리)
↓
<script type="application/ld+json">로 HTML에 Structured Data 제공
실제 서비스에서는 데이터의 출처와 특성에 따라 적절한 직렬화 방법이나 검증 전략을 함께 고려해야 합니다.
Schema.org와 JSON-LD는 무슨 관계일까?
JSON-LD를 처음 사용하면 @context와 @type 같은 값이 조금 낯설 수 있습니다.
{
  "@context": "https://schema.org",
  "@type": "Product"
}
여기서 Schema.org가 등장합니다.
Schema.org는 웹 페이지의 구조화 데이터를 표현하기 위해 사용할 수 있는 공통 Vocabulary(어휘)를 제공합니다.
쉽게 말하면 검색 엔진과 개발자가
이 데이터가 상품인지, 사람인지, 글인지, 조직인지
같은 의미를 공통된 방식으로 표현할 수 있도록 정의해놓은 Vocabulary입니다.
예를 들어 다음과 같은 타입들이 있습니다.
Product
Article
Person
Organization
Event
Recipe
...
그리고 타입에 따라 사용할 수 있는 속성들도 정의되어 있습니다.
Product
↓
name
description
image
offers
aggregateRating
...
따라서 관계를 단순하게 표현하면 다음과 같습니다.
- Schema.org →어떤 타입과 속성으로 데이터의 의미를 표현할지 정의
- JSON-LD →그 데이터를 실제 페이지에 표현하는 방법 중 하나
즉, JSON-LD 자체가 상품이나 게시글 같은 데이터 구조를 정의하는 것이 아닙니다.
Schema.org에서 정의된 Vocabulary를 JSON-LD 형식으로 표현할 수 있는 것입니다.
JSON-LD를 추가하면 검색 결과가 달라질까?
Structured Data를 적용하는 이유 중 하나는 Google의 Rich Result와 관련이 있습니다.
일반적인 검색 결과보다 추가적인 정보가 표시되는 검색 결과를 본 적이 있을 것입니다.
예를 들어 콘텐츠 종류에 따라 가격, 평점, 이미지 등의 추가 정보가 검색 결과에 활용될 수 있습니다.
일반 검색 결과

제목
설명
URL
Structured Data가 적절하게 적용된 콘텐츠는 지원되는 검색 기능에서 더 풍부한 형태로 표시될 가능성이 있습니다.
Rich Result

제목
설명
이미지
가격
평점
...
하지만 여기서도 중요한 점이 있습니다.
Structured Data를 추가했다고 Rich Result가 반드시 표시되는 것은 아닙니다.
올바른 Structured Data를 작성하는 것은 해당 검색 기능의 노출 자격을 갖추기 위한 조건 중 하나일 수 있지만, 실제 검색 결과에 해당 기능이 표시되는 것은 Google의 판단에 따라 달라질 수 있습니다.
또한 Schema.org에 존재하는 모든 타입과 속성이 Google Search의 Rich Result로 지원되는 것도 아닙니다.
따라서 Structured Data를 설계할 때는 다음 두 가지를 구분하는 것이 좋습니다.
- Schema.org → 웹에서 사용할 수 있는 광범위한 Structured Data Vocabulary
- Google Search → 그중 Google Search 기능에서 지원하는 타입과 속성 존재
즉, Schema.org에 정의되어 있다는 이유만으로 Google 검색 결과에 특별한 UI가 표시된다고 생각해서는 안 됩니다.
실제 적용 전에는 Google Search Central에서 해당 Structured Data 타입이 어떤 검색 기능을 지원하는지 확인하는 것이 좋습니다.
화면에 없는 정보를 JSON-LD에 추가해도 될까?
Structured Data를 사용하면서 주의해야 할 또 하나의 부분은 실제 페이지 콘텐츠와 Structured Data의 일치 여부입니다.
예를 들어 페이지에는 가격이 30,000원이라고 표시되어 있는데 JSON-LD에는 다른 가격을 넣는 식으로 데이터를 구성해서는 안 됩니다.
❌ 서로 다른 정보

사용자에게 보여주는 콘텐츠 → 30,000원
JSON-LD → 10,000원
Structured Data는 검색 엔진에게 보여주기 위한 별개의 콘텐츠를 만드는 수단이 아닙니다.
기본적으로 페이지에서 실제로 표현하고 있는 콘텐츠의 의미를 구조화해서 전달하는 것이라고 생각하는 것이 좋습니다.
따라서 데이터 구조를 다음과 같이 가져가는 것이 관리하기에도 좋습니다.
Server Data
↓
┌─────────────────────────────┐
│              │              │
▼              ▼              ▼
Metadata     HTML UI        JSON-LD
│              │              │
▼              ▼              ▼
페이지 정보   사용자 콘텐츠     구조화된 의미
동일한 원본 데이터를 기반으로 Metadata, 실제 화면, Structured Data를 생성하면 서로 다른 정보가 제공되는 문제도 줄일 수 있습니다.
정리
지금까지의 내용을 정리하면 다음과 같습니다.
- Rendering Strategy → 주요 콘텐츠가 포함된 결과 제공
- Semantic HTML → 문서의 구조와 의미 표현
- Metadata → 페이지에 대한 정보 제공
- Canonical → 대표 URL에 대한 신호 제공
- Structured Data → 콘텐츠의 의미를 구조적으로 표현
- JSON-LD → Structured Data를 페이지에 제공
여기까지 구성하면 검색 엔진이 페이지의 콘텐츠와 의미를 이해하는 데 필요한 여러 정보를 제공할 수 있습니다.
하지만 아직 한 가지 문제가 남아 있습니다.
아무리 잘 만들어진 페이지라도 검색 엔진이 URL을 발견하고 크롤링할 수 없다면 검색에 활용되기 어렵습니다.
또 Production에서는 검색 엔진의 크롤링을 허용하면서 Development나 Staging 환경에서는 크롤링을 제한하고 싶은 경우도 있습니다.
따라서 다음 Part2에서는 검색 엔진이 페이지를 발견하고 올바르게 수집하도록 만드는 방법을 살펴보겠습니다.
👉 Next.js에서 SEO를 설계하며 고려한 것들 - Part 2