- Published on
Next.js에서 SEO를 설계하며 고려한 것들 - Part 2
- Authors
- Name
- GW
개요
이전 글에서는 검색 엔진의 Crawling, Rendering, Indexing 과정부터
Next.js의 렌더링 전략, Semantic HTML, Metadata, Canonical URL, JSON-LD까지 살펴봤습니다.
👉 Next.js에서 SEO를 설계하며 고려한 것들 - Part 1
하지만 검색 엔진에게 페이지의 콘텐츠와 의미를 잘 전달하는 것만으로 SEO가 끝나는 것은 아닙니다.
아무리 잘 구성된 페이지라도 검색 엔진이 URL을 발견하고 크롤링할 수 없다면 검색에 활용되기 어렵기 때문입니다.
또한 실제 서비스를 운영하다 보면 Production에서는 검색 엔진의 접근을 허용하면서 Development나 Staging 환경에서는 크롤링을 제한하는 등 환경에 따라 서로 다른 SEO 정책이 필요할 수도 있습니다.
이번 글에서는 다음과 같은 내용을 중심으로 살펴보겠습니다.
- Sitemap을 활용한 URL 발견
- 외부 Sitemap과 Next.js Rewrite 구성
- robots.txt를 활용한 Crawling 관리
- robots.txt와 noindex의 차이
- Development, Staging, Production 환경별 SEO 정책
- Search Console을 활용한 검색 노출 검증
검색 엔진이 페이지를 발견하도록 만들기
앞에서는 검색 엔진에게 콘텐츠를 어떻게 제공하고, 페이지의 의미를 어떻게 전달할 수 있는지 살펴봤습니다.
하지만 아무리 잘 만들어진 페이지라도 검색 엔진이 URL을 발견하지 못한다면 검색 결과에 활용되기 어렵습니다.
따라서 SEO에서는 콘텐츠를 만드는 것뿐 아니라 검색 엔진이 어떤 URL을 발견하고 크롤링할 수 있는지도 함께 고려해야 합니다.
대표적으로 다음과 같은 요소들이 있습니다.
- Sitemap → 검색 엔진의 URL 발견 지원
- robots.txt → 검색 엔진 크롤러의 접근 범위 제어
- noindex → 검색 엔진의 색인 제어
각각 비슷해 보이지만 해결하는 문제는 서로 다릅니다.
먼저 Sitemap부터 살펴보겠습니다.
Sitemap은 왜 필요할까?
검색 엔진은 웹 페이지의 링크를 따라가면서 새로운 URL을 발견할 수 있습니다.
예를 들어 다음과 같은 구조가 있다고 해보겠습니다.
Home
↓
Product List
↓
Product Detail
검색 엔진이 Home을 크롤링하고 내부 링크를 따라가면 Product List와 Product Detail 페이지도 발견할 수 있습니다.
하지만 실제 서비스에서는 수백 개 또는 수천 개 이상의 동적 페이지가 존재할 수 있습니다.
/products/1
/products/2
/products/3
/products/4
...
모든 페이지가 항상 다른 페이지에서 쉽게 연결되어 있다고 보장할 수도 없습니다.
예를 들어 사이트 구조가 깊어지면 Home에서 여러 단계를 거쳐야만 도달할 수 있는 페이지가 생길 수 있습니다.
검색 엔진은 내부 링크를 따라가며 URL을 발견하지만, 이런 페이지는 크롤링 과정에서 놓치기 쉽습니다.
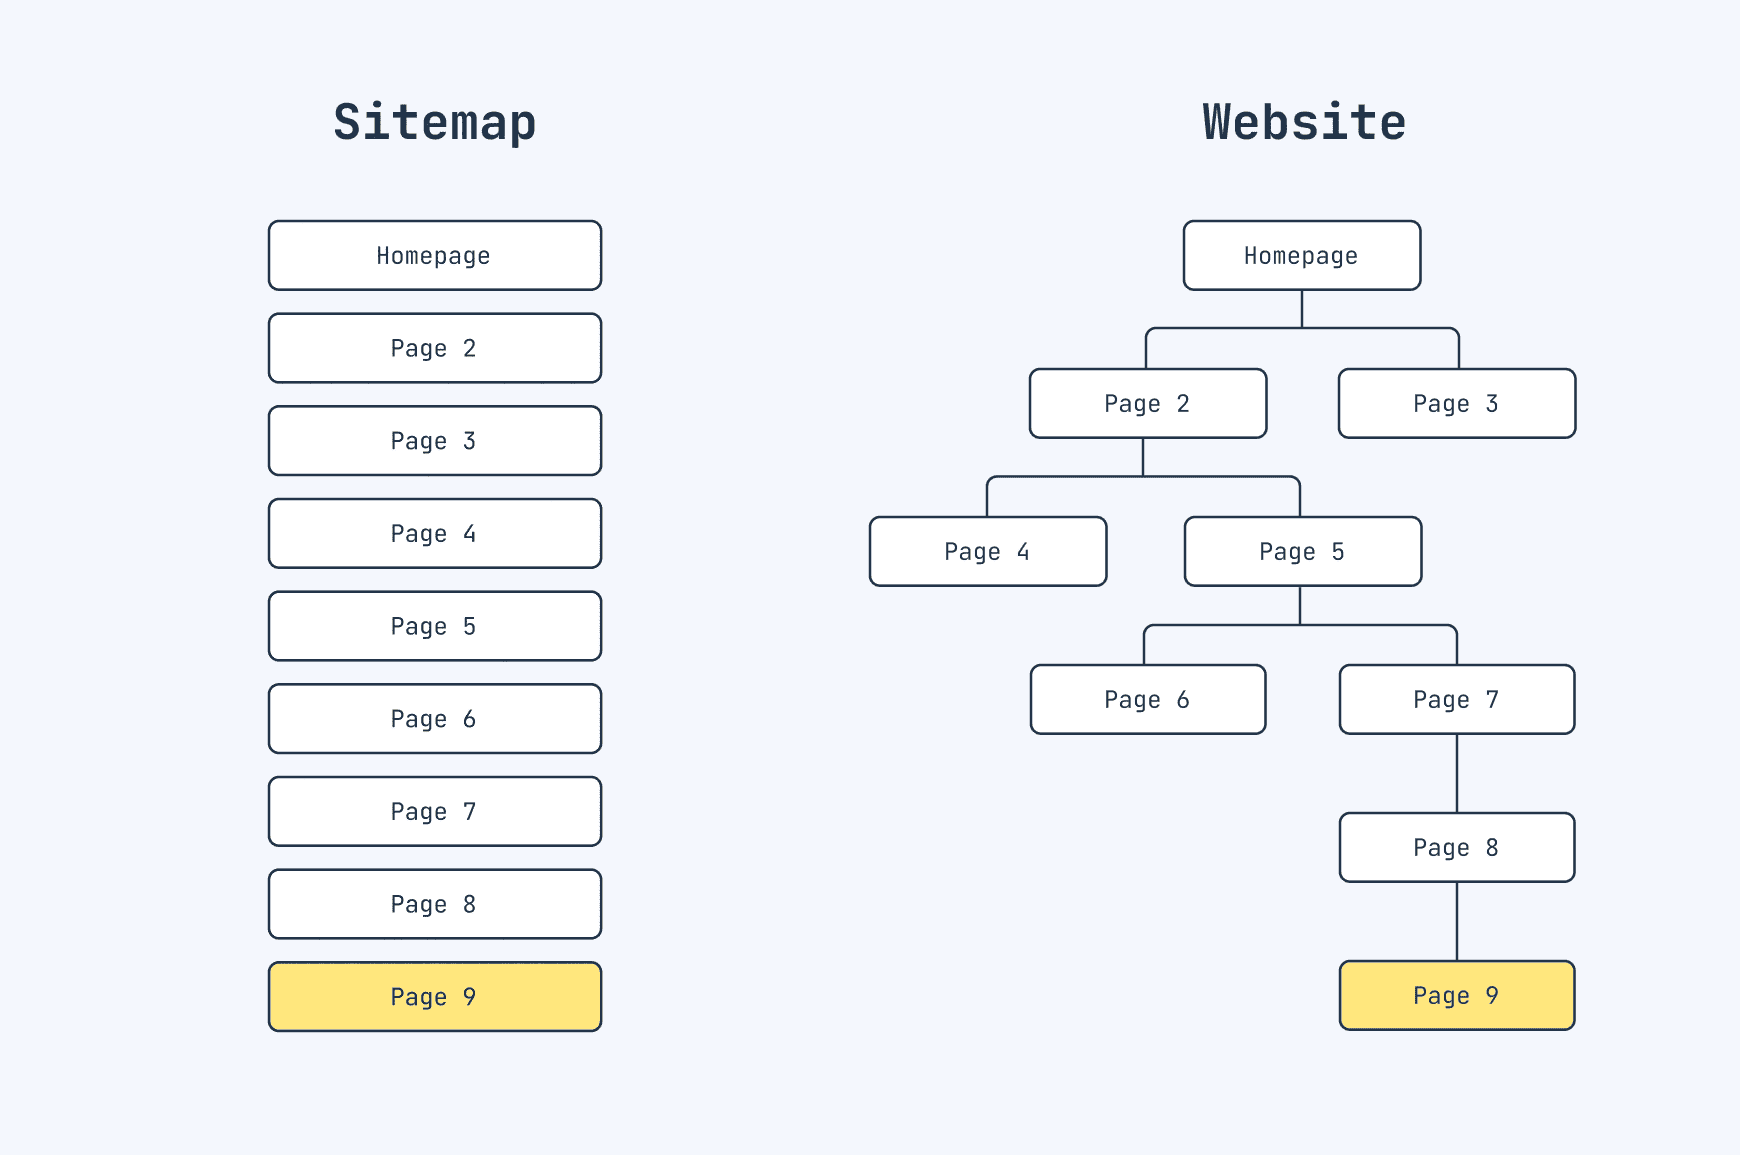
반면 Sitemap은 사이트의 URL을 평평한 목록으로 정리해 제공합니다.
깊은 계층에 있는 페이지도 Sitemap에 포함하면 검색 엔진이 URL을 더 쉽게 발견할 수 있습니다.
이때 검색 엔진에게 사이트에서 중요하게 생각하는 URL을 알려주는 방법 중 하나가 Sitemap 입니다.
Google은 Sitemap을 사이트의 페이지, 동영상, 기타 파일과 그 관계에 대한 정보를 제공하는 파일이라고 설명합니다.
*Google Search Central - Build and submit a sitemap
일반적인 XML Sitemap은 다음과 같은 형태입니다.
<?xml version="1.0" encoding="UTF-8"?>

<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://example.com/</loc>
  </url>

  <url>
    <loc>https://example.com/products</loc>
  </url>

  <url>
    <loc>https://example.com/products/1</loc>
  </url>
</urlset>
검색 엔진은 sitemap.xml을 확인하여 사이트에서 제공하는 URL 목록을 파악하고, 이를 통해 크롤링할 페이지를 발견할 수 있습니다.
하지만 여기서 중요한 점이 있습니다.
Sitemap에 URL을 추가했다고 해당 페이지의 Crawling이나 Indexing이 보장되는 것은 아닙니다.
Sitemap은 검색 엔진이 URL을 발견하도록 도와주는 수단입니다.
Google은 Sitemap에 포함된 URL을 참고하여 크롤링할 수 있지만 실제 크롤링과 색인 여부는 별도로 결정합니다.
따라서 다음과 같이 이해하는 것이 좋습니다.
- Sitemap 등록 ≠ 검색 결과 등록 보장
- Sitemap 등록 → URL 발견을 돕는 신호
Next.js에서 Sitemap 생성하기
Next.js App Router에서는 sitemap.ts라는 Metadata File Convention을 제공합니다.
예를 들어 다음과 같이 작성할 수 있습니다.
import type { MetadataRoute } from 'next';

const BASE_URL = 'https://example.com';

export default function sitemap(): MetadataRoute.Sitemap {
  return [
    { url: BASE_URL, lastModified: new Date() },
    { url: `${BASE_URL}/products`, lastModified: new Date() },
  ];
}
Next.js는 이를 기반으로 /sitemap.xml을 제공할 수 있습니다.
정적인 URL만 존재한다면 이렇게 직접 구성하는 것도 가능합니다.
하지만 실제 서비스에서는 동적으로 생성되는 페이지가 많을 수 있습니다.
예를 들어 상품 데이터를 이용해 Sitemap을 생성할 수 있습니다.
import type { MetadataRoute } from 'next';

const BASE_URL = 'https://example.com';

export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const products = await getProducts();

  const productUrls = products.map((product) => ({
    url: `${BASE_URL}/products/${product.id}`,
    lastModified: product.updatedAt,
  }));

  return [
    { url: BASE_URL, lastModified: new Date() },
    { url: `${BASE_URL}/products`, lastModified: new Date() },
    ...productUrls,
  ];
}
이제 새로운 상품이 추가되면 해당 데이터를 기반으로 Sitemap에 URL을 포함시킬 수 있습니다.
새로운 상품 데이터 추가
↓
상품 데이터를 기반으로 URL 생성
↓
sitemap.ts에서 Sitemap 생성
↓
sitemap.xml에 상품 URL 포함
↓
검색 엔진이 새로운 상품 URL 발견
이 방식의 장점은 서비스 데이터와 Sitemap을 연결할 수 있다는 것입니다.
동적 페이지가 많아질수록 모든 URL을 개발자가 직접 XML에 추가하는 방식은 관리하기 어렵기 때문에 데이터에 기반해 Sitemap을 생성하는 것이 더 적합할 수 있습니다.
Sitemap에는 어떤 URL을 넣어야 할까?
Sitemap을 단순히 "사이트에 존재하는 모든 URL 목록" 으로 생각하기 쉽습니다.
하지만 모든 접근 가능한 URL을 무조건 추가하는 것은 좋은 접근이 아닙니다.
Google은 Sitemap에 검색 결과에 표시되기를 원하는 Canonical URL을 포함하도록 안내합니다.
예를 들어 다음 URL들이 동일한 콘텐츠를 제공한다고 가정해 보겠습니다.
https://example.com/products/1
https://example.com/products/1?ref=home
https://example.com/products/1?utm_source=example
Canonical URL을 다음과 같이 정했다면
https://example.com/products/1
Sitemap에도 일반적으로 이 URL을 포함하는 것이 좋습니다.
Canonical → https://example.com/products/1
Sitemap → https://example.com/products/1
Google은 같은 콘텐츠를 가진 여러 URL이 있을 때, 어떤 URL을 대표 URL로 사용할지 결정합니다.
이때 개발자는 여러 방법을 통해 Google에게 어떤 URL을 대표 URL로 사용하면 좋을지 신호를 보낼 수 있습니다.
대표적으로 Redirect, rel="canonical", Sitemap 등이 있으며, 각 방법이 Google에 전달하는 신호의 강도에는 차이가 있습니다.
- Redirect(강한 신호) → "이 URL 대신 다른 URL을 사용하세요"
- rel="canonical"(강한 신호) → "이 페이지의 대표 URL은 이 URL입니다"
- Sitemap(상대적으로 약한 신호) → "사이트에서 중요하게 관리하는 URL은 이것입니다"
즉, Sitemap에 특정 URL을 포함하는 것만으로 대표 URL이 반드시 결정되는 것은 아니지만, Google이 대표 URL을 판단할 때 참고하는 신호 중 하나로 사용될 수 있습니다.
따라서 Sitemap과 rel="canonical"에서 서로 다른 URL을 가리키기보다 같은 URL을 일관되게 사용하여 어떤 URL이 대표 URL인지 명확하게 알려주는 것이 좋습니다.
Sitemap이 너무 커지면 어떻게 해야 할까?
서비스 규모가 커지면 Sitemap 하나에 모든 URL을 담기 어려울 수 있습니다.
Google의 Sitemap 규격에서는 Sitemap 하나의 크기를
- 최대 50,000 URLs
- 또는 압축하지 않은 상태에서 최대 50MB
로 제한합니다.
이를 초과한다면 Sitemap을 여러 개로 나누어야 합니다.
예를 들어 다음과 같이 구성할 수 있습니다.
sitemap.xml
↓
products-sitemap-1.xml
products-sitemap-2.xml
products-sitemap-3.xml
...
Next.js 역시 큰 애플리케이션을 위해 여러 Sitemap을 생성할 수 있는 generateSitemaps API를 제공합니다.
import type { MetadataRoute } from 'next';

const BASE_URL = 'https://example.com';

export async function generateSitemaps() {
  return [{ id: 0 }, { id: 1 }, { id: 2 }];
}

export default async function sitemap({
  id,
}: {
  id: Promise<string>;
}): Promise<MetadataRoute.Sitemap> {
  const sitemapId = Number(await id);

  const products = await getProducts({
    page: sitemapId,
    limit: 50000,
  });

  return products.map((product) => ({
    url: `${BASE_URL}/products/${product.id}`,
    lastModified: product.updatedAt,
  }));
}
즉, 서비스 규모가 커지더라도 하나의 거대한 Sitemap을 유지할 필요는 없습니다.
Sitemap이 다른 시스템에서 만들어진다면?
모든 서비스가 Next.js 애플리케이션 내부에서 Sitemap을 생성하는 것은 아닙니다.
예를 들어 다음과 같은 구조도 생각해볼 수 있습니다.
Next.js Application → 웹 페이지를 제공
별도의 Sitemap System → sitemap.xml을 생성
Sitemap을 별도의 서버나 시스템에서 생성하고 있지만 외부에서는 다음 URL로 제공하고 싶다고 가정해 보겠습니다.
https://example.com/sitemap.xml
이런 경우 Next.js의 Rewrite를 활용하는 방법을 고려할 수 있습니다.
Next.js 공식 문서에서는 Rewrite를 들어오는 요청 경로를 다른 목적지 경로에 매핑하는 기능으로 설명합니다.
예를 들어 다음과 같이 구성할 수 있습니다.
import type { NextConfig } from 'next';

const nextConfig: NextConfig = {
  async rewrites() {
    return [
      {
        source: '/sitemap.xml',
        destination: 'https://sitemap.example.net/sitemap.xml',
      },
    ];
  },
};

export default nextConfig;
외부에서는 다음과 같이 요청합니다.
https://example.com/sitemap.xml
하지만 Next.js 내부에서는 요청을 외부 Sitemap으로 연결합니다.
Search Engine
↓
https://example.com/sitemap.xml
↓
Next.js Rewrite
↓
https://sitemap.example.net/sitemap.xml
↓
Sitemap Response
이 구조에서는 Sitemap을 생성하는 시스템과 실제 웹 서비스를 제공하는 시스템의 역할을 분리하면서도 서비스 도메인의 URL을 통해 Sitemap을 제공할 수 있습니다.
Rewrite와 Redirect는 무엇이 다를까?
여기서 Rewrite와 Redirect의 차이를 이해하는 것도 중요합니다.
Redirect를 사용하면 클라이언트가 새로운 URL로 이동합니다.
Request

example.com/sitemap.xml
↓
Redirect
↓
sitemap.example.net/sitemap.xml
↓
URL 변경
반면 Rewrite는 Next.js가 요청을 다른 목적지에 매핑하면서 외부에 보이는 URL을 유지할 수 있습니다.
Request

example.com/sitemap.xml
↓
Rewrite
↓
내부적으로 외부 Sitemap 요청
↓
Response

브라우저 / 클라이언트가 보는 URL
example.com/sitemap.xml
Next.js 공식 문서에서도 Rewrite를 URL Proxy처럼 동작하면서 destination path를 감추는 기능으로 설명합니다.
따라서
Redirect
→ 클라이언트가 다른 URL로 이동

Rewrite
→ 요청을 다른 리소스에 연결
→ 외부 URL은 유지
라는 차이가 있습니다.
이러한 특성을 이용하면 Sitemap이 다른 시스템에서 관리되는 구조에서도 서비스 도메인의 /sitemap.xml을 진입점으로 유지할 수 있습니다.
robots.txt는 무엇을 제어할까?
Sitemap이 검색 엔진에게 발견했으면 하는 URL을 알려주는 역할이라면 robots.txt는 검색 엔진 크롤러가 어떤 URL에 접근할 수 있는지를 제어하는 역할을 합니다.
Google은 robots.txt를 검색 엔진 크롤러가 사이트에서 접근할 수 있는 URL을 알려주는 파일이라고 설명합니다.
*Google Search Central - robots.txt
예를 들어 다음과 같이 작성할 수 있습니다.
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /search/
Disallow: /private/
의미는 다음과 같습니다.
User-agent: *
↓
모든 크롤러를 대상으로

Allow: /
↓
기본적으로 크롤링 허용

Disallow: /admin/
Disallow: /search/
Disallow: /private/
↓
/admin/, /search/, /private/ 경로 크롤링 제한
Sitemap 위치도 robots.txt에 함께 제공할 수 있습니다.
크롤러는 사이트에 접근할 때 robots.txt를 먼저 확인하는 경우가 많습니다.
여기에 Sitemap URL을 함께 적어두면, 검색 엔진이 Sitemap 위치를 더 쉽게 찾을 수 있습니다.
User-agent: *
Allow: /

Sitemap: https://example.com/sitemap.xml
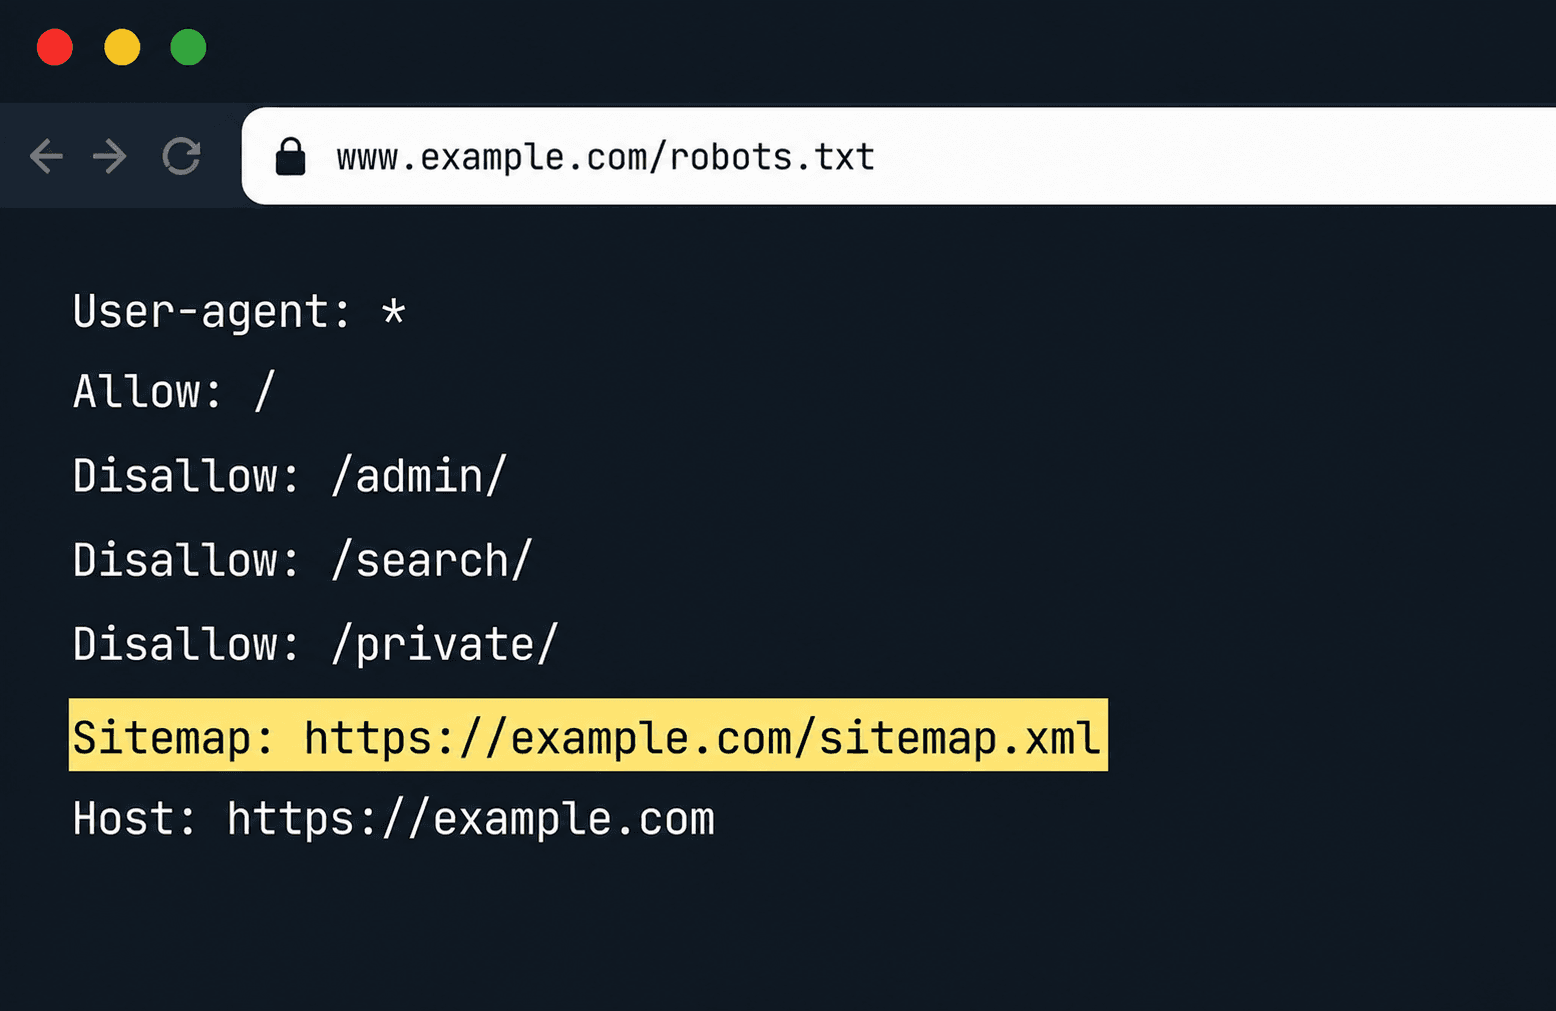
즉 robots.txt는 크롤링 허용 범위를 정의하는 동시에, Sitemap의 위치를 알려주는 진입점 역할도 할 수 있습니다.
Next.js App Router에서는 robots.ts를 이용해 이를 생성할 수도 있습니다.
import type { MetadataRoute } from 'next';

export default function robots(): MetadataRoute.Robots {
  return {
    rules: {
      userAgent: '*',
      allow: '/',
      disallow: ['/admin/', '/search/', '/private/'],
    },
    sitemap: 'https://example.com/sitemap.xml',
  };
}
Next.js는 이를 /robots.txt로 제공합니다.
robots.txt로 막으면 검색 결과에서도 사라질까?
robots.txt를 이해할 때 가장 많이 혼동하는 부분입니다.
다음과 같이 생각하기 쉽습니다.
robots.txt
↓
Disallow
↓
Google이 페이지를 크롤링하지 않음
↓
검색 결과에도 나오지 않음
하지만 정확하지 않습니다.
robots.txt의 기본적인 목적은 Crawling을 제어하는 것이지 Indexing을 직접 제어하는 것이 아닙니다.
Google 공식 문서에서도 robots.txt를 웹 페이지를 Google 검색 결과에서 숨기는 방법으로 사용해서는 안 된다고 설명합니다.
다른 페이지에서 해당 URL을 링크하고 있다면 Google이 페이지 콘텐츠를 직접 크롤링하지 않았더라도 URL 자체를 발견할 수 있기 때문입니다.
따라서 다음 두 개념을 구분해야 합니다.
- Crawling: 검색 엔진이 페이지에 접근하고 콘텐츠를 가져오는 것
- Indexing: 가져온 페이지를 분석하여 검색 결과에 활용할 수 있도록 Google의 검색 시스템에 등록하는 것
그리고 각각을 제어하는 대표적인 방법도 다릅니다.
robots.txt
↓
Crawling 제어

noindex
↓
Indexing 제어
noindex는 어떻게 동작할까?
페이지를 Google 검색 결과에서 제외하고 싶다면 noindex를 사용할 수 있습니다.
HTML에서는 다음과 같이 작성할 수 있습니다.
<meta name="robots" content="noindex, nofollow" />
Googlebot이 페이지를 크롤링하고 이 값을 확인하면 해당 페이지를 Google Search의 색인에서 제외합니다.
Next.js에서는 Metadata API를 이용해 설정할 수도 있습니다.
import type { Metadata } from 'next';

export const metadata: Metadata = {
  robots: {
    index: false,
    follow: false,
  },
};
여기서 각각의 옵션은 다음과 같은 의미를 가집니다.
index: false:noindex로 설정되어 해당 페이지를 검색 결과에 색인하지 않도록 합니다.follow: false:nofollow로 설정되어 해당 페이지 안에 있는 링크를 검색 엔진이 따라가지 않도록 합니다.
검색 결과에서 페이지를 제외하는 것과 직접적으로 관련된 옵션은 noindex이며, nofollow는 페이지 내부 링크를 탐색하는 것과 관련된 별개의 옵션입니다.
개념적으로는 다음과 같습니다.
Googlebot
↓
페이지 Crawling
↓
HTML 확인
↓
noindex 발견
↓
Indexing 하지 않음
여기서 매우 중요한 부분이 있습니다.
noindex가 동작하려면 검색 엔진이 페이지를 크롤링할 수 있어야 합니다.
왜냐하면 검색 엔진이 페이지에 접근해야 HTML이나 HTTP Header에 존재하는 noindex를 확인할 수 있기 때문입니다.
따라서 다음과 같이 구성하면 문제가 생길 수 있습니다.
robots.txt
↓
Disallow: /private/
↓
Googlebot이 페이지를 Crawling하지 않음
↓
페이지 내부의 noindex를 읽을 수 없음
Google 공식 문서에서도 noindex가 효과적으로 동작하려면 해당 페이지가 robots.txt로 차단되어서는 안 된다고 명확하게 설명합니다.
*Google Search Central - Block Search indexing with noindex
개발·스테이징 환경은 어떻게 관리해야 할까?
실제 서비스를 운영하다 보면 Production 외에도 여러 환경이 존재할 수 있습니다.
Development
Staging
Production
예를 들어 Staging 환경이 외부에서 접근 가능한 URL을 가지고 있다고 가정해 보겠습니다.
https://staging.example.com
Production과 동일하거나 유사한 콘텐츠가 Staging에서도 제공된다면 검색 엔진에게 테스트 환경이 발견되는 것을 원하지 않을 수 있습니다.
이때 중요한 것은 크롤링을 막는 것과 검색 결과 노출을 막는 것을 구분해서 생각하는 것입니다.
단순히 다음과 같이 설정하는 것만으로
User-agent: *
Disallow: /
Staging URL이 검색 결과에 절대 나타나지 않는다고 보장할 수는 없습니다.
앞에서 살펴봤듯 robots.txt는 크롤링을 제어하는 수단이기 때문입니다.
예를 들어 검색 엔진은 다른 페이지의 링크 등을 통해 Staging URL 자체를 발견할 수 있기 때문에,
페이지의 크롤링을 차단하더라도 URL이 검색 결과에 나타날 가능성이 있습니다.
검색 결과에 노출되어서는 안 되는 환경이라면 요구사항에 따라
- 접근 인증
- noindex
- robots.txt
등의 방법을 각각의 목적에 맞게 검토해야 합니다.
특히 내부 테스트 환경이나 외부에 공개되어서는 안 되는 환경이라면 단순한 SEO 설정보다 인증을 통해 접근 자체를 제한하는 방식이 더 적절할 수 있습니다.
robots.txt → Crawler 접근 정책

noindex → 검색 색인 정책

Authentication → 리소스 자체의 접근 제한
이 셋은 서로 해결하는 문제가 다릅니다.
따라서
테스트 환경이니까 robots.txt에서 전부 막으면 된다.
라고 단순하게 접근하기보다 해당 환경을 왜 차단하려는지부터 구분하는 것이 중요합니다.
환경에 따라 robots 정책을 다르게 구성하기
Next.js의 robots.ts는 코드로 생성할 수 있기 때문에 배포 환경에 따라 서로 다른 정책을 구성할 수도 있습니다.
예를 들어 개념적으로 다음과 같은 정책을 생각해볼 수 있습니다.
Production
→ Crawler 허용
→ Sitemap 제공
Non-Production
→ 별도의 Crawling / Indexing 정책 적용
코드로 표현하면 다음과 같은 형태가 될 수 있습니다.
import type { MetadataRoute } from 'next';

const BASE_URL = 'https://example.com';

export default function robots(): MetadataRoute.Robots {
  const isProduction = process.env.NODE_ENV === 'production';

  if (!isProduction) {
    return {
      rules: {
        userAgent: '*',
        disallow: '/',
      },
    };
  }

  return {
    rules: {
      userAgent: '*',
      allow: '/',
    },
    sitemap: `${BASE_URL}/sitemap.xml`,
  };
}
다만 실제 배포 환경에서는 NODE_ENV만으로 Production과 Staging을 구분할 수 없는 경우가 많습니다.
Staging 배포도 next build를 거쳐 NODE_ENV=production으로 실행될 수 있기 때문입니다.
따라서 실제 서비스에서는 별도의 환경 변수를 두는 방식이 더 명확할 수 있습니다.
APP_ENV=production
APP_ENV=staging
APP_ENV=development
예를 들어 다음과 같습니다.
import type { MetadataRoute } from 'next';

const BASE_URL = 'https://example.com';

export default function robots(): MetadataRoute.Robots {
  const isProduction = process.env.APP_ENV === 'production';

  if (!isProduction) {
    return {
      rules: {
        userAgent: '*',
        disallow: '/',
      },
    };
  }

  return {
    rules: {
      userAgent: '*',
      allow: '/',
    },
    sitemap: `${BASE_URL}/sitemap.xml`,
  };
}
이렇게 하면 SEO 정책 역시 배포 환경에 따라 다르게 관리할 수 있습니다.
배포 환경 확인
↓
환경에 맞는 robots.txt 설정
↓
Production            → Crawling 허용
Development / Staging → Crawling 제한
↓
검색 엔진의 Crawling 범위 결정
다만 앞서 살펴봤듯 Disallow: /는 검색 엔진의 크롤링을 제한하는 설정이므로,
이것만으로 해당 URL이 검색 결과에서 반드시 제외된다고 보장할 수는 없습니다.
SEO 작업은 어떻게 검증할까?
SEO 관련 코드를 구현했다고 해서 작업이 끝나는 것은 아닙니다.
실제로 검색 엔진이 우리가 의도한 방식으로 페이지를 확인하고 있는지 검증해야 합니다.
Google에서는 이를 위한 여러 도구를 제공합니다.
Google Search Console
대표적인 도구가 Google Search Console입니다.
Search Console에서는 사이트의 검색 노출 상태와 색인 관련 정보를 확인할 수 있습니다.
Sitemap을 생성했다면 Search Console의 Sitemaps 메뉴에서 /sitemap.xml URL을 제출할 수 있습니다.
Google은 제출된 Sitemap을 참고해 사이트의 URL을 발견하는 데 활용합니다.
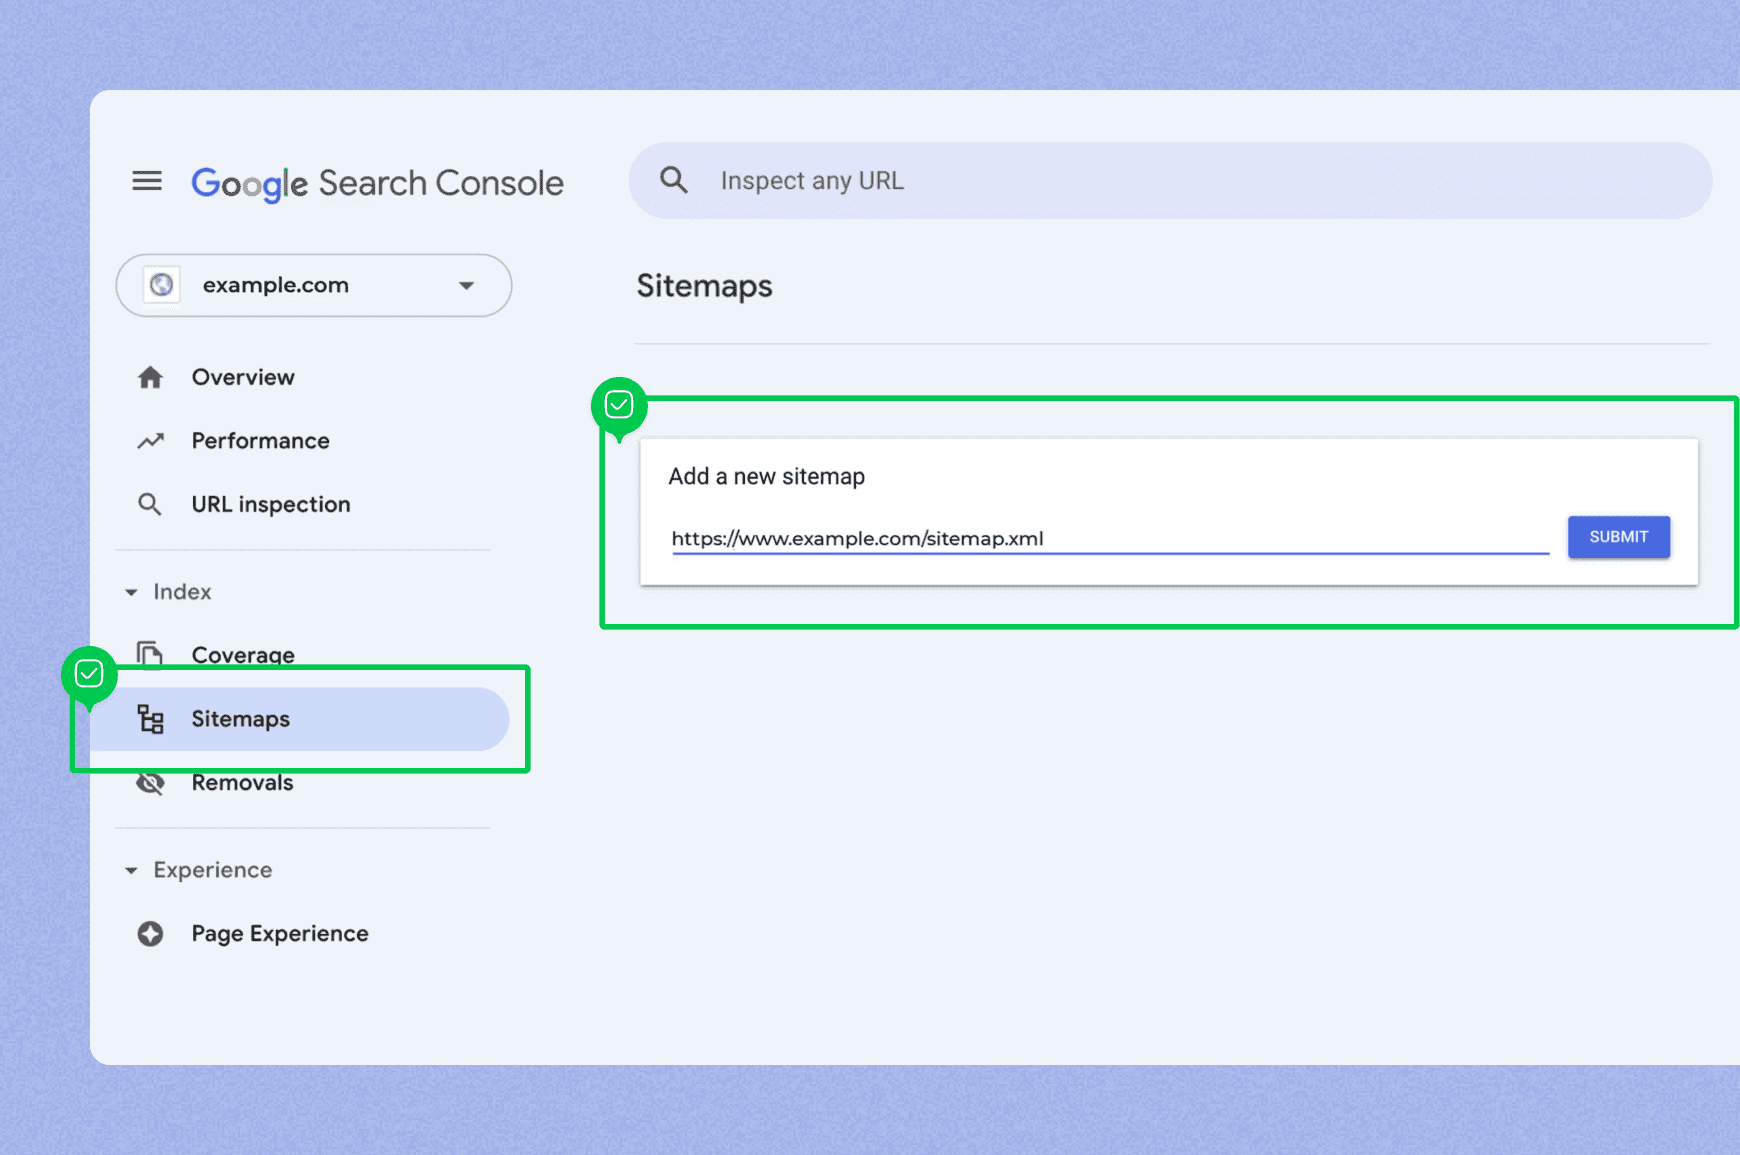
다만 Sitemap을 제출했다고 모든 URL이 자동으로 색인되는 것은 아닙니다.
제출은 URL 발견을 돕는 신호일 뿐이며, 실제 색인 여부는 별도로 확인해야 합니다.
특정 URL에 대해서는 URL Inspection을 사용할 수 있습니다.
URL Inspection을 이용하면 Google이 해당 URL에 대해 가지고 있는 색인 정보 등을 확인할 수 있습니다.
JavaScript 기반 페이지의 문제를 확인할 때도 유용합니다.
Google 공식 문서에서는 JavaScript 관련 검색 문제를 디버깅할 때 URL Inspection 또는 Rich Results Test를 이용해 Google이 페이지를 어떻게 크롤링하고 렌더링하는지 확인하도록 안내합니다.
*Google Search Central - Fix Search-related JavaScript problems
예를 들어 다음과 같은 항목을 확인할 수 있습니다.
- Google이 해당 URL에 접근할 수 있는지
- 페이지가 Google에 색인되어 있는지
- 어떤 URL이 Canonical URL로 선택되었는지
- Google이 페이지를 어떻게 렌더링하는지
- Crawling이나 Indexing 과정에서 문제가 발생했는지
단순히 브라우저에서 페이지가 정상적으로 보인다는 것만으로 검색 엔진에서도 동일하게 처리된다고 가정하지 않는 것이 중요합니다.
Rich Results Test
JSON-LD와 같은 Structured Data를 적용했다면 Google의 Rich Results Test를 이용해 지원되는 구조화 데이터가 올바르게 인식되는지 확인할 수 있습니다.
JSON-LD 작성
↓
Rich Results Test로 검사
↓
구조화 데이터(Structured Data)가 올바르게 인식되는지 확인
↓
오류 / 경고 확인
↓
문제가 있다면 수정
다만 테스트를 통과했다고 실제 검색 결과에서 Rich Result가 반드시 표시되는 것은 아닙니다.
올바른 Structured Data는 Rich Result의 노출 가능성을 위한 조건일 수 있지만 실제 노출 여부는 Google이 결정합니다.
Search Console의 검색 성과 확인
SEO 개선의 최종 목적은 단순히 설정을 추가하는 것이 아닙니다.
실제로 검색 결과에서 페이지가 어떻게 노출되고 사용자가 얼마나 유입되는지도 확인해야 합니다.
대표적으로 다음과 같은 지표를 살펴볼 수 있습니다.
- Impressions: 검색 결과 노출 수
- Clicks: 검색 결과 클릭 수
- CTR: 노출 대비 클릭 비율
- Position: 검색 결과에서의 평균 게재순위
다만 SEO 작업 이후 자연 검색 유입이 증가했다고 해서 특정 코드 하나가 증가의 원인이라고 단정하는 건 주의해야 합니다.
검색 유입에는 다양한 요소가 영향을 줄 수 있습니다.
- 콘텐츠 품질
- 검색 수요
- 검색 순위
- 경쟁 페이지
- Metadata
- 사이트 구조
- 외부 링크
- 알고리즘 변화
- 계절성 등등
따라서 SEO 개선 결과를 분석할 때는 특정 구현 하나의 효과라고 단정하기보다 여러 변경 사항과 Search Console의 데이터를 함께 살펴보는 것이 좋습니다.
결국 SEO는 하나의 기능으로 해결되지 않는다
지금까지 살펴본 내용을 처음부터 다시 연결해보겠습니다.
검색 엔진이 페이지를 검색 결과에 활용하기까지는 여러 과정이 존재합니다.
URL 발견
↓
페이지 Crawling
↓
페이지 Rendering
↓
콘텐츠 분석 및 이해
↓
Indexing 여부 결정
↓
검색 결과에 노출될 수 있음
그리고 각각의 과정에서 개발자가 고려할 수 있는 요소도 다릅니다.
- Rendering Strategy → 주요 콘텐츠를 어떤 방식으로 제공할 것인가?
- Semantic HTML → 문서 구조와 의미를 어떻게 표현할 것인가?
- Metadata → 페이지 정보를 어떻게 제공할 것인가?
- Canonical → 대표 URL을 어떻게 제공할 것인가?
- Structured Data / JSON-LD → 콘텐츠의 의미를 어떻게 구조화해서 전달할 것인가?
- Sitemap → 검색 엔진의 URL 발견을 어떻게 도울 것인가?
- robots.txt → 어떤 URL의 Crawling을 허용할 것인가?
- noindex → 어떤 페이지의 Indexing을 제한할 것인가?
이렇게 보면 SEO는 단순히 SSR 적용이나 Metadata 추가 같은 하나의 작업으로 해결되는 문제가 아니라는 것을 알 수 있습니다.
각 기술은 서로 다른 문제를 해결합니다.
마치며
처음 SEO를 접했을 때는 title, description 같은 Metadata를 설정하거나 SSR을 적용하는 것이 핵심이라고 생각하기 쉽습니다.
하지만 실제로 살펴보면 SEO는 검색 엔진이 웹 페이지를 처리하는 전체 과정과 연결되어 있습니다.
Next.js는 이 과정에서 활용할 수 있는 다양한 기능을 제공합니다.
- Server Rendering
- Metadata API
- generateMetadata
- Semantic HTML
- JSON-LD
- Canonical
- sitemap.ts
- robots.ts
- rewrites
하지만 중요한 것은 이러한 기능을 많이 사용하는 것 자체가 아닙니다.
각 기능이 검색 엔진의 어떤 문제를 해결하기 위해 존재하는지 이해하고 필요한 곳에 사용하는 것이 더 중요합니다.
예를 들어 SSR은 주요 콘텐츠가 포함된 결과를 제공하는 데 활용할 수 있고,
Metadata는 페이지 자체의 정보를 전달하며, JSON-LD는 콘텐츠의 의미를 구조화된 형태로 표현합니다.
Sitemap은 URL 발견을 돕고 robots.txt는 크롤링 정책을 제어합니다.
검색 엔진의 동작 원리 이해
↓
페이지 특성 파악
↓
적절한 Rendering Strategy 선택
↓
콘텐츠와 문서 구조 설계
↓
Metadata / Structured Data 구성
↓
Canonical URL 관리
↓
Sitemap / Robots 정책 구성
↓
Search Console을 통한 검증
↓
검색 성과 확인 및 개선
결국 SEO를 설계한다는 것은 단순히 몇 개의 SEO 설정을 추가하는 작업이 아니라,
검색 엔진이 페이지를 발견하고, 가져오고, 이해하고, 적절하게 색인할 수 있도록 전체 흐름을 설계하는 과정
이라고 볼 수 있습니다.
그리고 이 과정에서 가장 중요하게 느낀 것은 특정 SEO 기술을 적용하는 것보다 각 기술이 해결하려는 문제가 무엇인지 이해하는 것이었습니다.
따라서 SEO를 구현할 때는
SEO를 위해 무엇을 추가해야 할까?
보다
현재 검색 엔진이 이 페이지를 발견하고 이해하는 과정에서 어떤 문제가 있는가?
를 먼저 생각하는 것이 더 좋은 출발점이라고 생각합니다.
👉 Next.js에서 SEO를 설계하며 고려한 것들 - Part 1